Build School Logo
  • Microsoft Cert. Roadmap
    • Microsoft Certificate Courses
    • Microsoft Azure
    • Azure DevOps
    • Power Platform
    • Power BI
    • Cyber Security Certificate
    • AI
  • AI 培訓補助
    • 抓住培訓補助! AI 商業應用實戰班:ChatGPT與Gemini 產業應用情境與案例
    • Microsoft 365 Copilot AI 培訓補助來囉
    • AI 驅動開發:從構思到上線 – GitHub Copilot 企業開發實戰
    • AI-102 微軟AI工程師認證
    • 更多AI認證課程
  • Courses
  • AI產品一站式服務
    • 各廠模型高CP值-AI GPT企業學校多人共用版
    • 影像編輯更方便-AI Design 企業學校共用版
    • Google Gemini AI Pro for Education 教育版
  • Shop
  • AI Insightful
    • AI, Cloud, Full-Stack Engineer Bootcamp
    • Tips for Certificate Exam
    • How To Learn on Build School Learn
  • About Us
    • Build School
    • FAQ
  • English
    • 繁體中文 (Chinese (Traditional))
    • 日本語 (Japanese)

No products in the cart.

Login
  • Microsoft Cert. Roadmap
    • Microsoft Certificate Courses
    • Microsoft Azure
    • Azure DevOps
    • Power Platform
    • Power BI
    • Cyber Security Certificate
    • AI
  • AI 培訓補助
    • 抓住培訓補助! AI 商業應用實戰班:ChatGPT與Gemini 產業應用情境與案例
    • Microsoft 365 Copilot AI 培訓補助來囉
    • AI 驅動開發:從構思到上線 – GitHub Copilot 企業開發實戰
    • AI-102 微軟AI工程師認證
    • 更多AI認證課程
  • Courses
  • AI產品一站式服務
    • 各廠模型高CP值-AI GPT企業學校多人共用版
    • 影像編輯更方便-AI Design 企業學校共用版
    • Google Gemini AI Pro for Education 教育版
  • Shop
  • AI Insightful
    • AI, Cloud, Full-Stack Engineer Bootcamp
    • Tips for Certificate Exam
    • How To Learn on Build School Learn
  • About Us
    • Build School
    • FAQ
  • English
    • 繁體中文 (Chinese (Traditional))
    • 日本語 (Japanese)
logotype

No products in the cart.

  • English
    • 繁體中文(Chinese (Traditional))
    • 日本語(Japanese)
Login
logotype
  • Microsoft Certification Roadmap
  • Certificate Exams
    • Microsoft Azure
    • Azure DevOps
    • Power Platform
    • Power BI
    • Cyber Security Certificate
    • AI
  • Courses
  • Blog: AI Insightful
    • Tips for Certificate Exam
  • About Us
    • FAQs
  • AI 培訓補助
  • AI產品一站式服務
    • 多廠模型高CP值-AI GPT企業學校多人共用版
    • 影像編輯更方便-Al Design 企業學校共用版
    • Google Gemini AI Pro for Education 教育版簡介
  • Shop
  • My Profile
資訊分享
Home 資訊分享 Page 2

Category: 資訊分享

AI資訊分享Build School Learn2026-02-24
Share article:TwitterFacebookLinkedin
531 Views
24 Likes

你到底讓 AI Agent 自己跑多久?從 Claude Code 的報告實測: 看懂「自主性、監督、風險」三件事

如果你用過 coding agent,應該遇過這種瞬間:它看起來很順,下一秒卻開始改到你不想動的檔案;或是你本來想手動核准每一步,但任務一長就覺得「一直按同意」根本不現實。於是問題變成:我們到底讓 AI 自己跑多久?怎麼盯?盯到什麼程度才算安全?

本文把一份針對 Claude Code 與公開 API 的大規模互動觀測研究,用更貼近工程團隊日常的角度重寫:從「怎麼定義 Agent」、到「怎麼量測自主性」、再到「風險在哪裡開始冒出來」。你可以把它當作建立內部治理指標與監控儀表板的參考模板。

先講結論:多數 Agent 行為仍偏低風險、可逆;但自主性正在上升,且資安、金融、醫療等高風險領域已出現早期使用。想要安全擴大自主性,靠「每步都人工核准」不夠,得靠部署後監控與更好的介入機制。

先把話講清楚:什麼算 Agent?不是聊天機器人就算

工程師最怕概念空轉,所以直接用可落地的定義:Agent = 會用工具、能採取行動的 AI 系統。工具可能是:

  • 跑程式碼、改檔案、下指令
  • 呼叫外部 API(查資料、建票、觸發工作流)
  • 發訊息或協調其他 Agent

為什麼這樣定義重要?因為你只要能把「工具呼叫」當成基本事件,就能做監控、做審計、做風險分級,不需要先把 Agent 的內部架構講得像論文一樣完整。

兩種觀測視角:API 看廣度、Claude Code 看深度

要研究「大家在真實世界怎麼用 Agent」,有兩個常見痛點:

  • 供應商未必看得到客戶完整系統(你用什麼 orchestrator、外面還接了什麼人審流程)。
  • 就算看得到流量,也不一定能把零散請求串成同一個 Session。

因此研究採用兩個互補資料源:

  • 公開 API(廣):可以看到很多不同客戶、很多領域,但多半只能以單次工具呼叫分析,無法完整重建長任務的「連續行為」。
  • Claude Code(深):因為是第一方產品,能把一次任務從頭到尾串起來,看它連續跑多久、何時停、停的原因是人類打斷還是它自己問問題。

而且研究使用隱私保護的分析方法,只做彙總與分類,不直接用人工逐筆看內容。

自主性怎麼量?用一個直覺但有用的指標:它連續工作多久才停

在 Claude Code 這種互動式 coding agent 裡,有個很直覺的量法:從它開始動手到它停下來(完成、被打斷、或自己問問題)的時間,當成每一回合的「自主工作時長」。它不是完美指標,因為模型速度、並行子代理、任務難度都會影響,但對理解真實使用很有幫助。

觀測結果有兩層:

  • 多數回合很短:中位數大約 45 秒,幾個月內大致在 40–55 秒浮動。
  • 長尾在變長:最長那批使用案例,在三個月內,停止前的自主工作時長幾乎翻倍(以 99.9 百分位衡量,從不到 25 分鐘到超過 45 分鐘)。
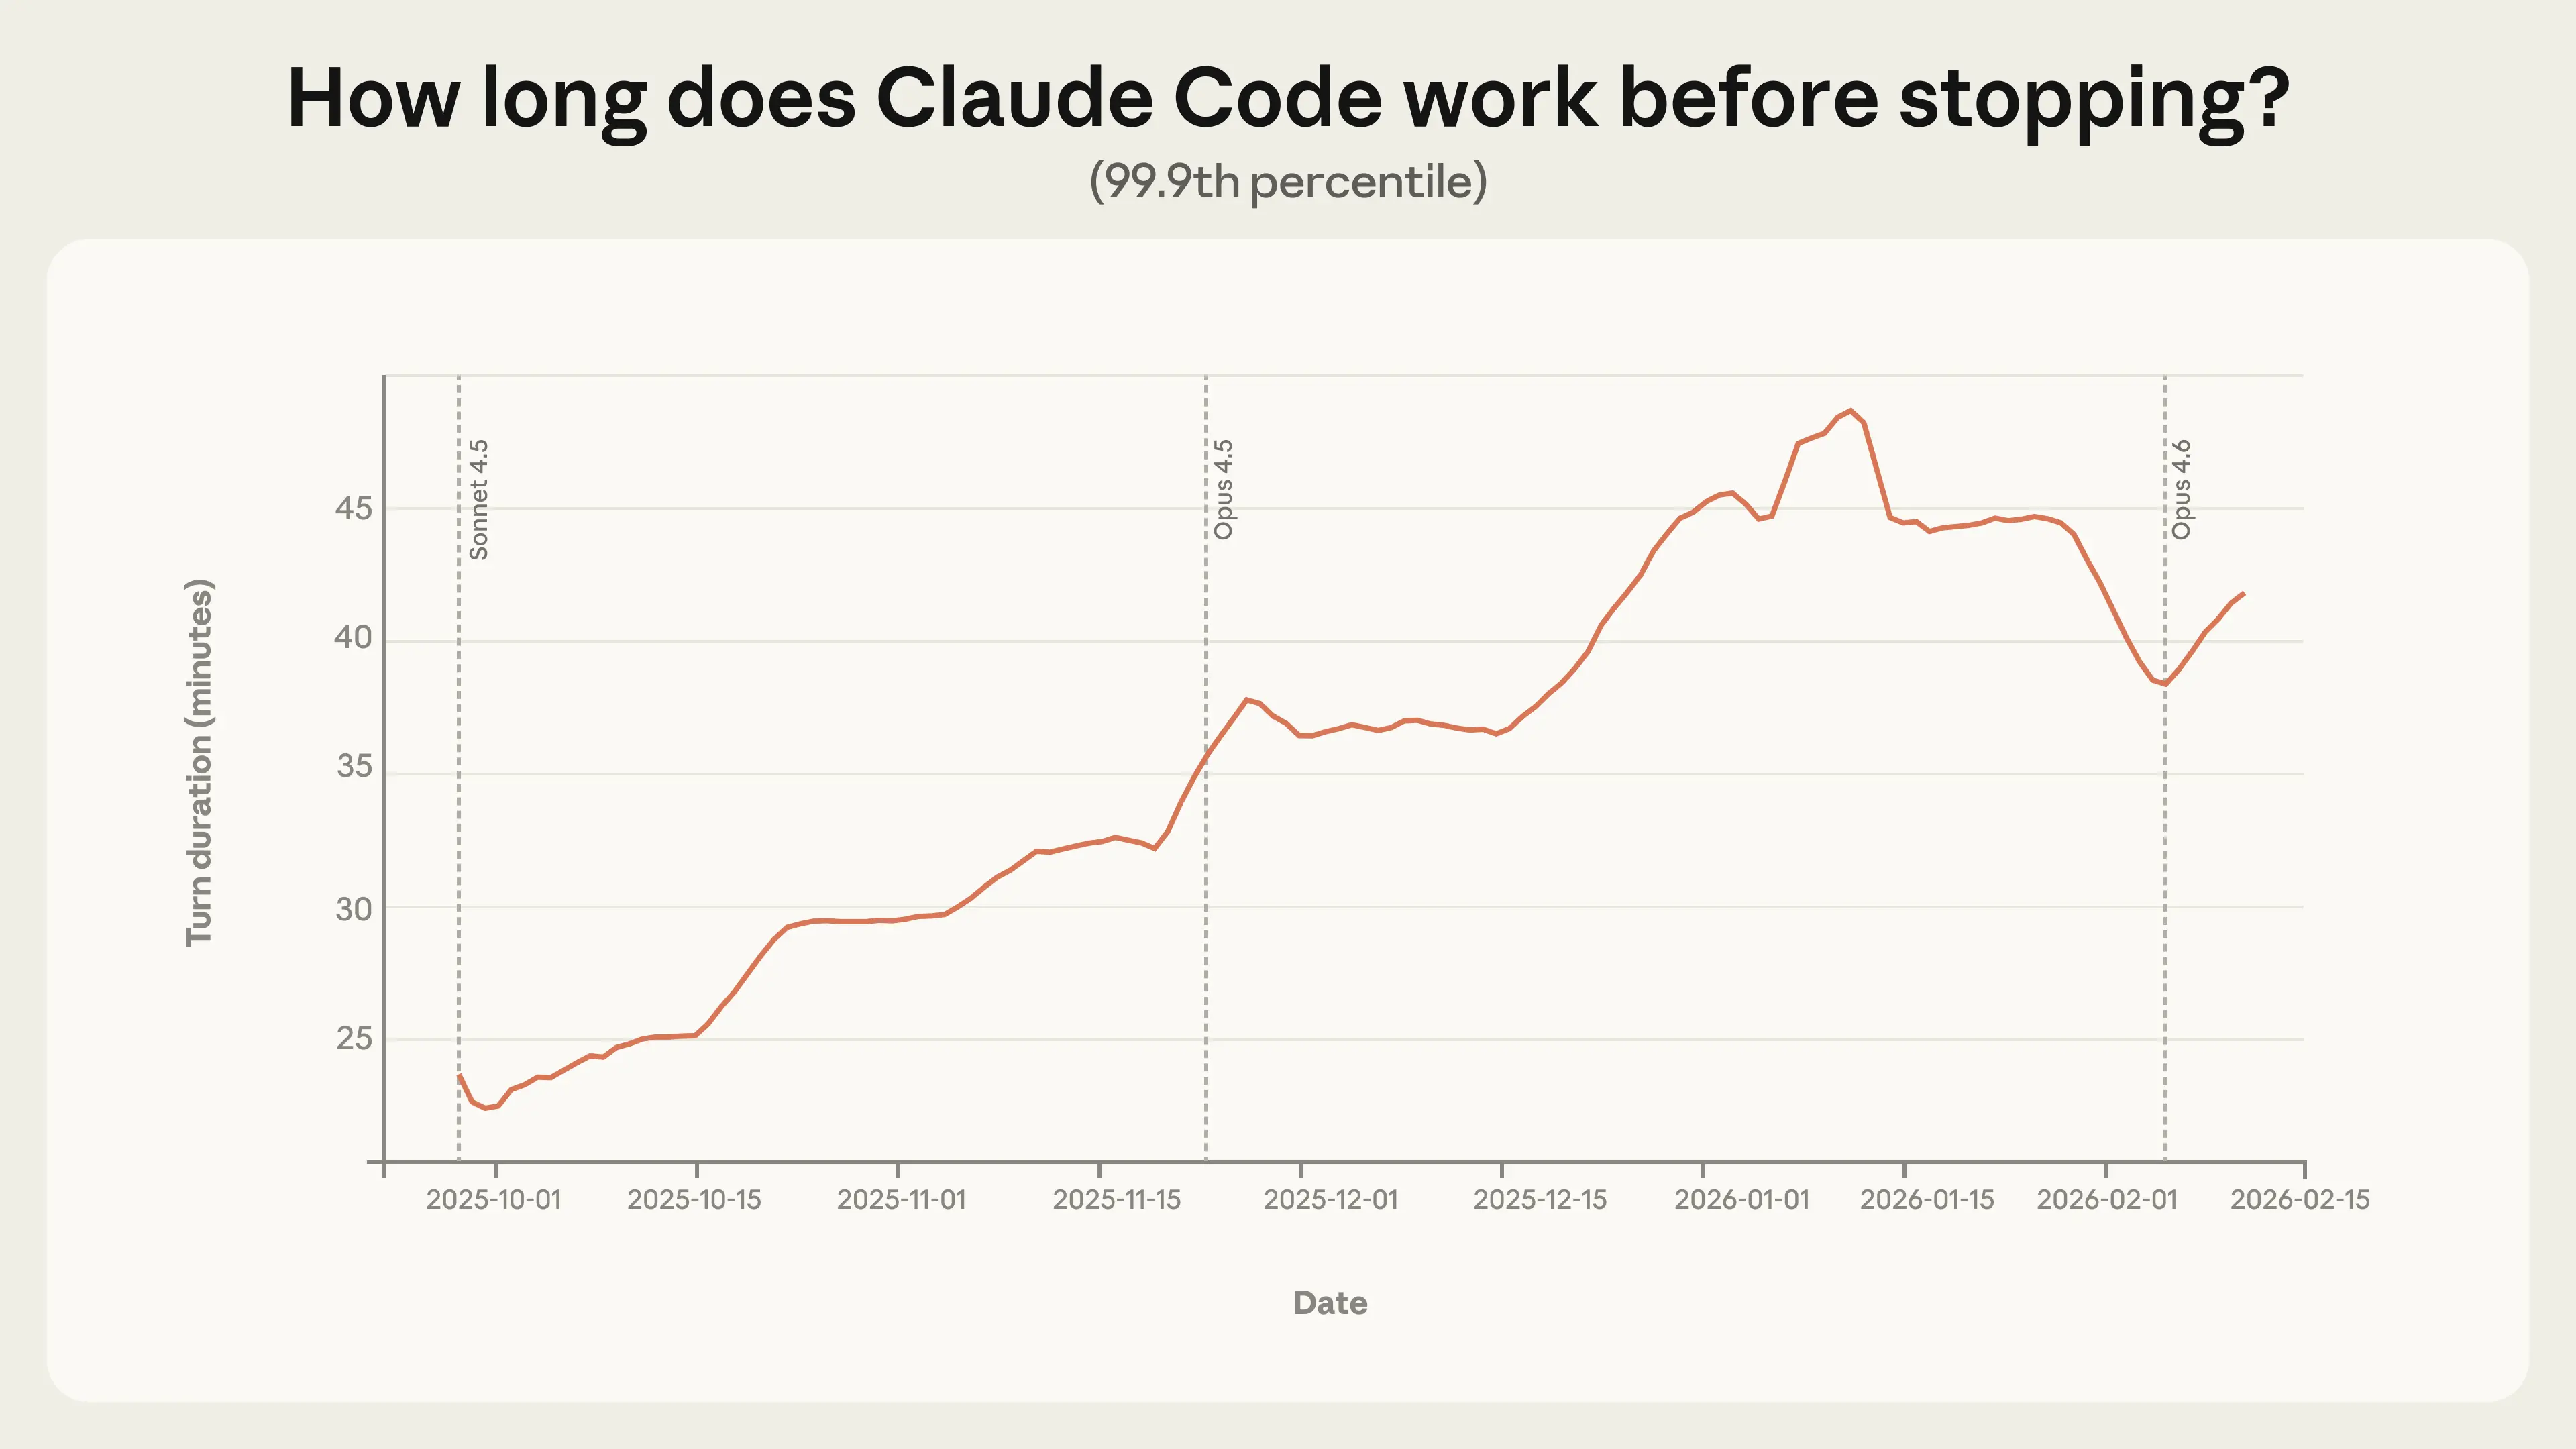
如果你是帶團隊導入的人,這很像一個訊號:當大家越用越熟、越敢把任務丟大,Agent 就會被允許跑更久。更妙的是,這個變長趨勢跨模型更新很平滑,暗示「信任、工作流、產品設計」的影響,可能不亞於模型本身能力提升。

資深使用者的監督策略很「現實」:少按核准、多用中斷修正

很多治理制度直覺會走向「每一步都要人核准」,但實際使用不一定這樣。觀測顯示:

  • 使用者越資深,全自動核准(auto-approve)越常開:新手大約 20% 的 Session 使用全自動,資深可到 40% 以上。
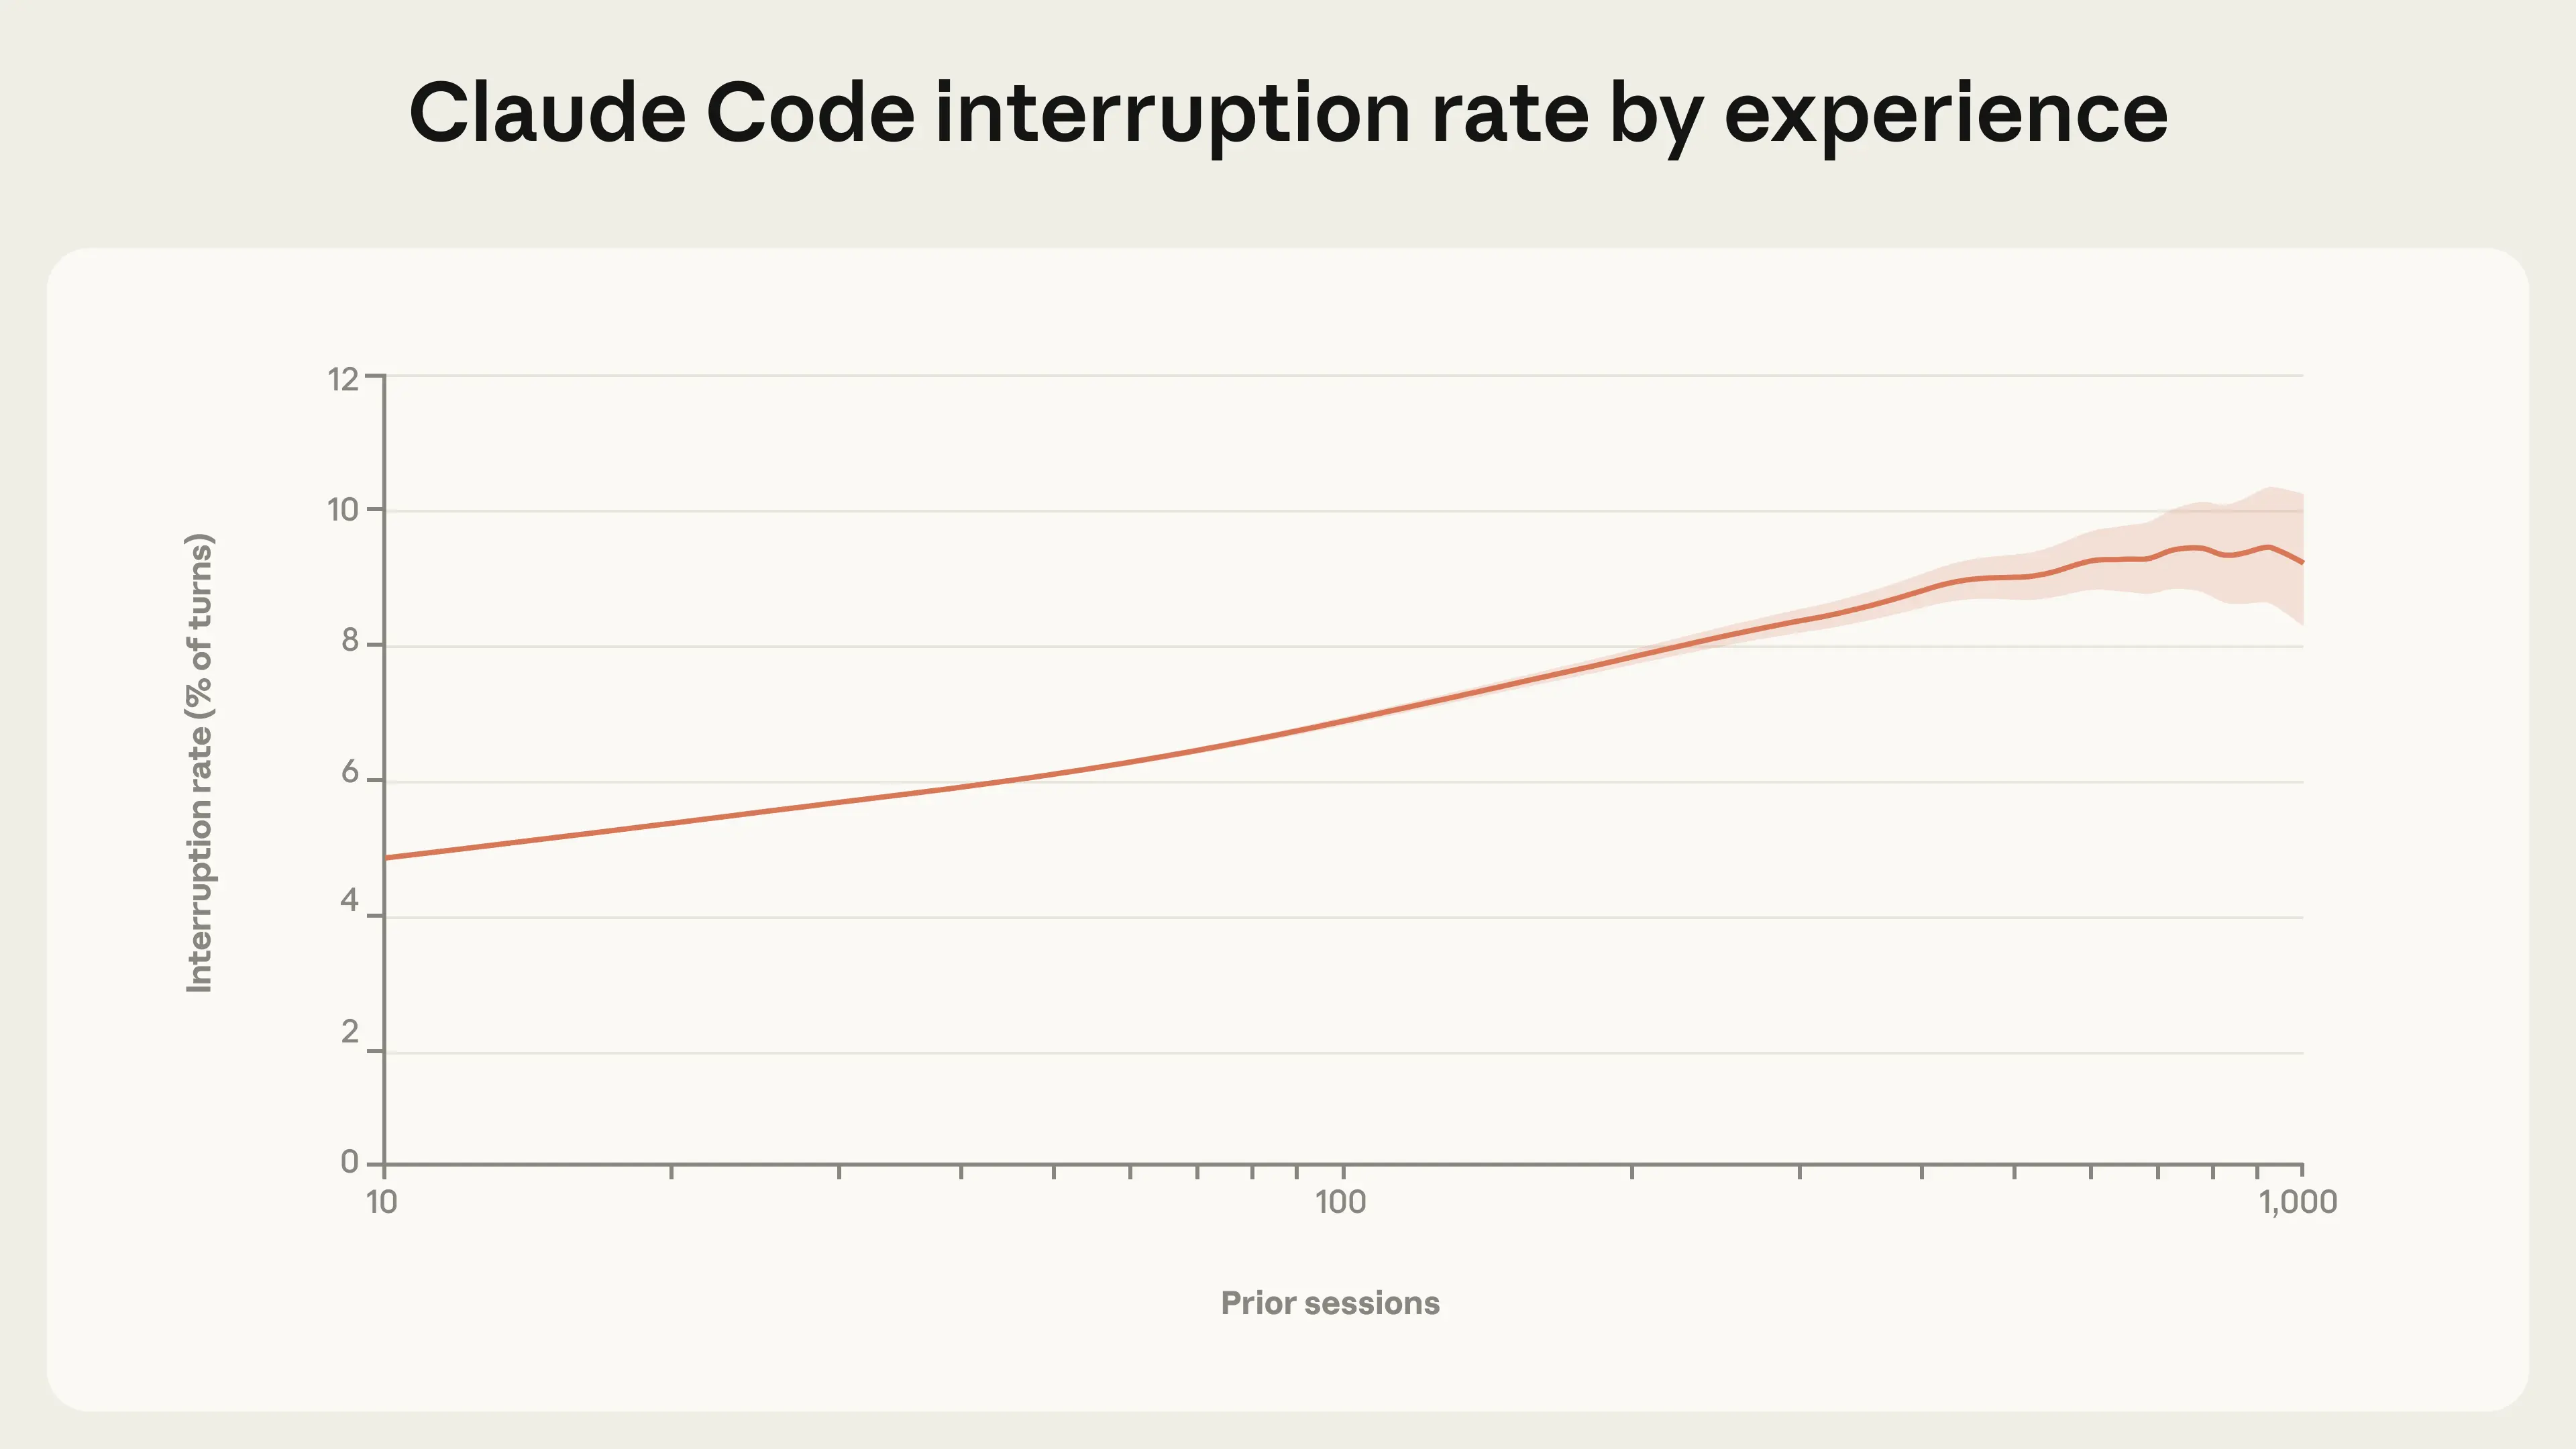
  • 同時,使用者越資深,中斷(interrupt)也越常發生:新手約 5% 的回合中斷,資深約 9%。
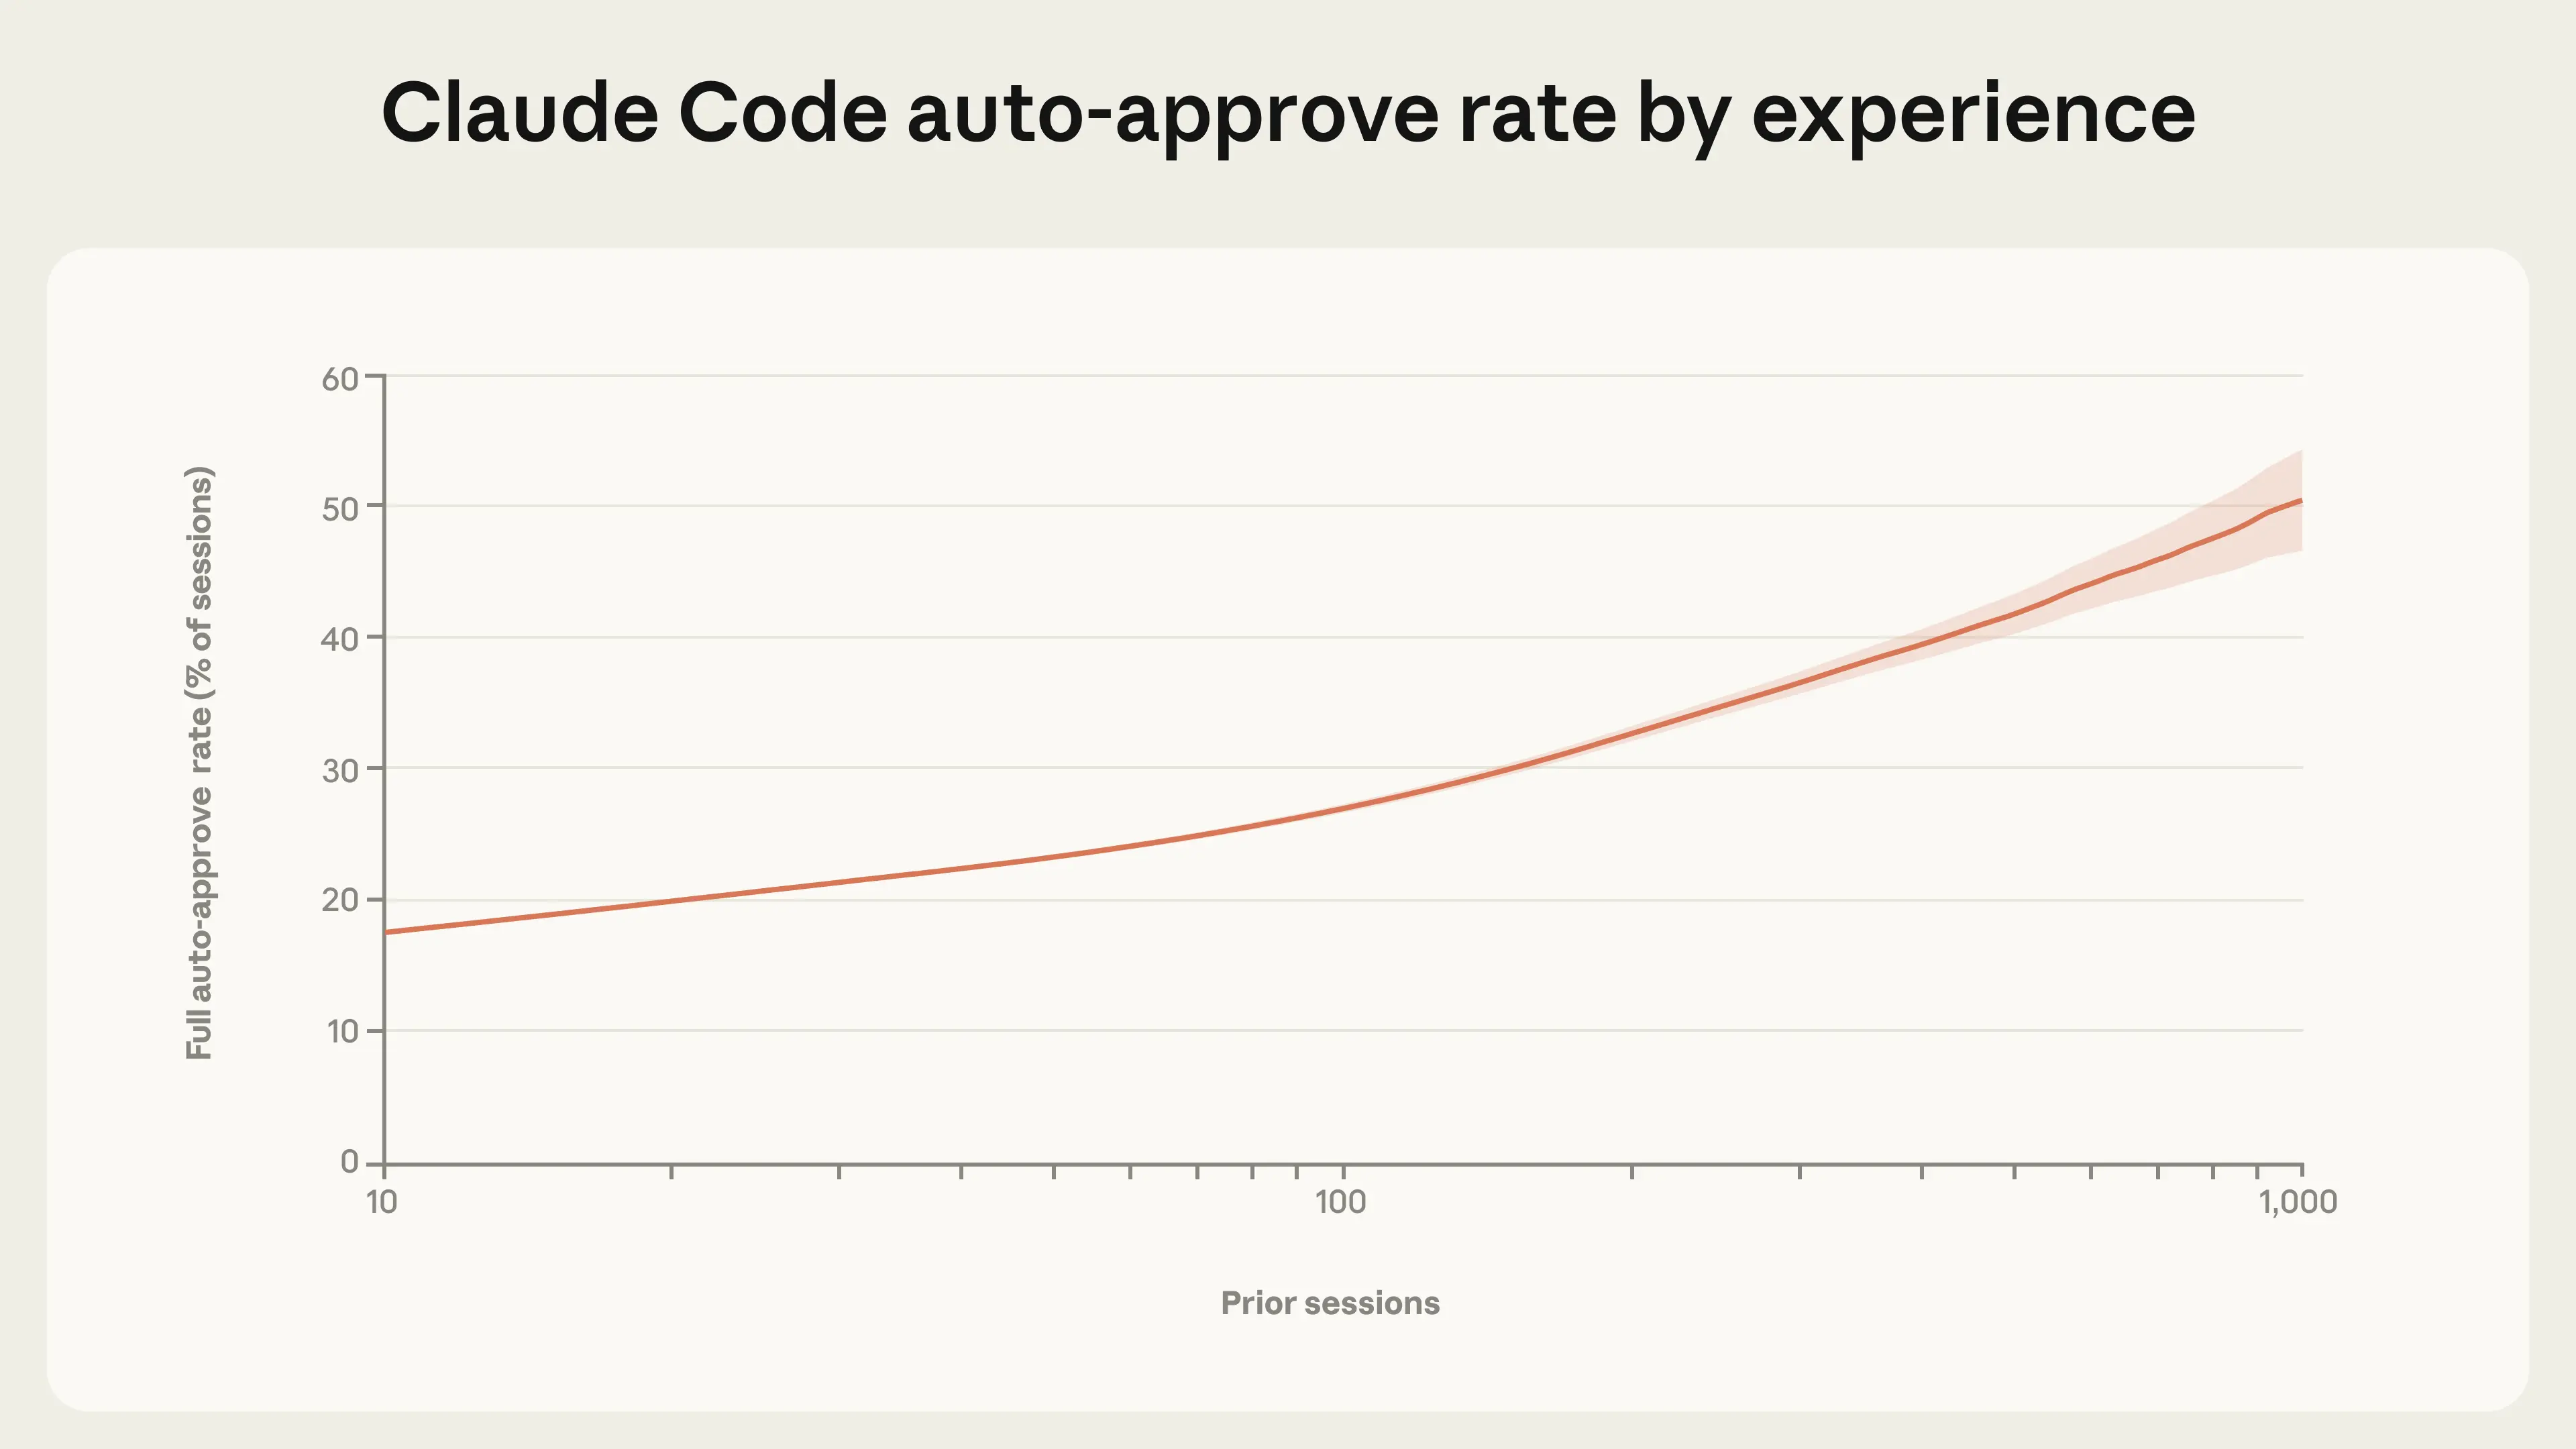
這其實超像工程師的日常:一開始不放心,想逐步看;但任務變長後,你會改成讓它跑,自己盯進度、看到不對就喊停、補上下文、修正方向。也就是從「事前核准」轉成「過程監看 + 必要時介入」。

對團隊流程的啟示:不要把「按不按核准」當成唯一安全指標,反而要問:你是否提供足夠可觀測性(它現在做什麼、要做什麼、為什麼)、以及足夠低成本的介入方式(中斷、回滾、鎖權限、改目標)。

不只是人類在盯:Agent 自己停下來問問題,其實也是一種安全機制

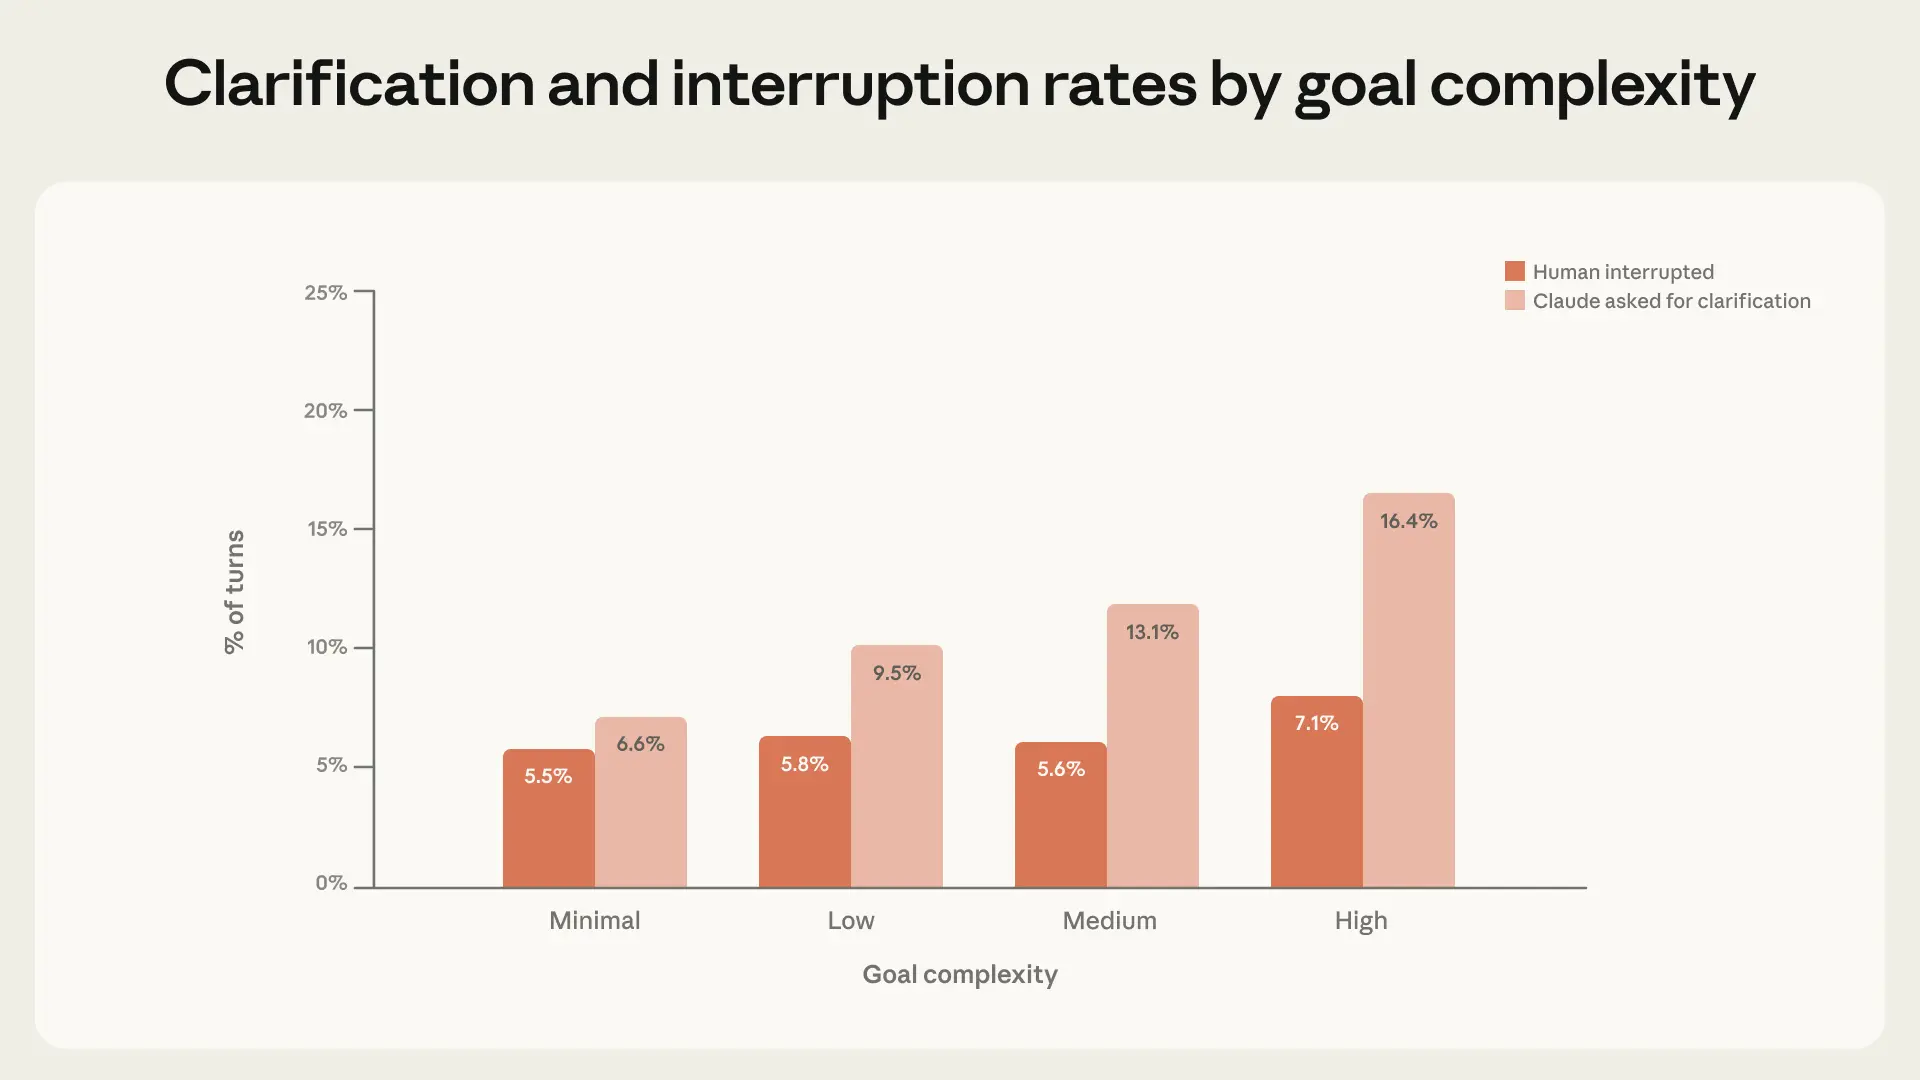
另一個很實用的觀測是:在複雜任務中,Claude Code 會更常停下來問澄清問題,而且頻率比人類中斷更高,最複雜任務甚至是人類中斷的兩倍以上。

把常見原因翻成工程師語言,大概是:

  • 它自己停下來:要你選 A/B 方案、要你提供測試結果或診斷資訊、需求不清楚要你補、缺 token/權限、或它覺得該先確認再動手。
  • 你把它喊停:你發現上下文錯了、你想改需求、它卡住/太慢、或你已經拿到足夠提示想自己做下一步(例如跑測試、部署、commit)。
落地建議:把「會停下來問對問題」視為 Agent 的核心能力之一。你可以要求它在高風險工具前先輸出計畫與假設,並把不確定點變成明確的確認清單。

風險在哪裡?大多低風險可逆,但右上角(高風險/高自主)不是空的

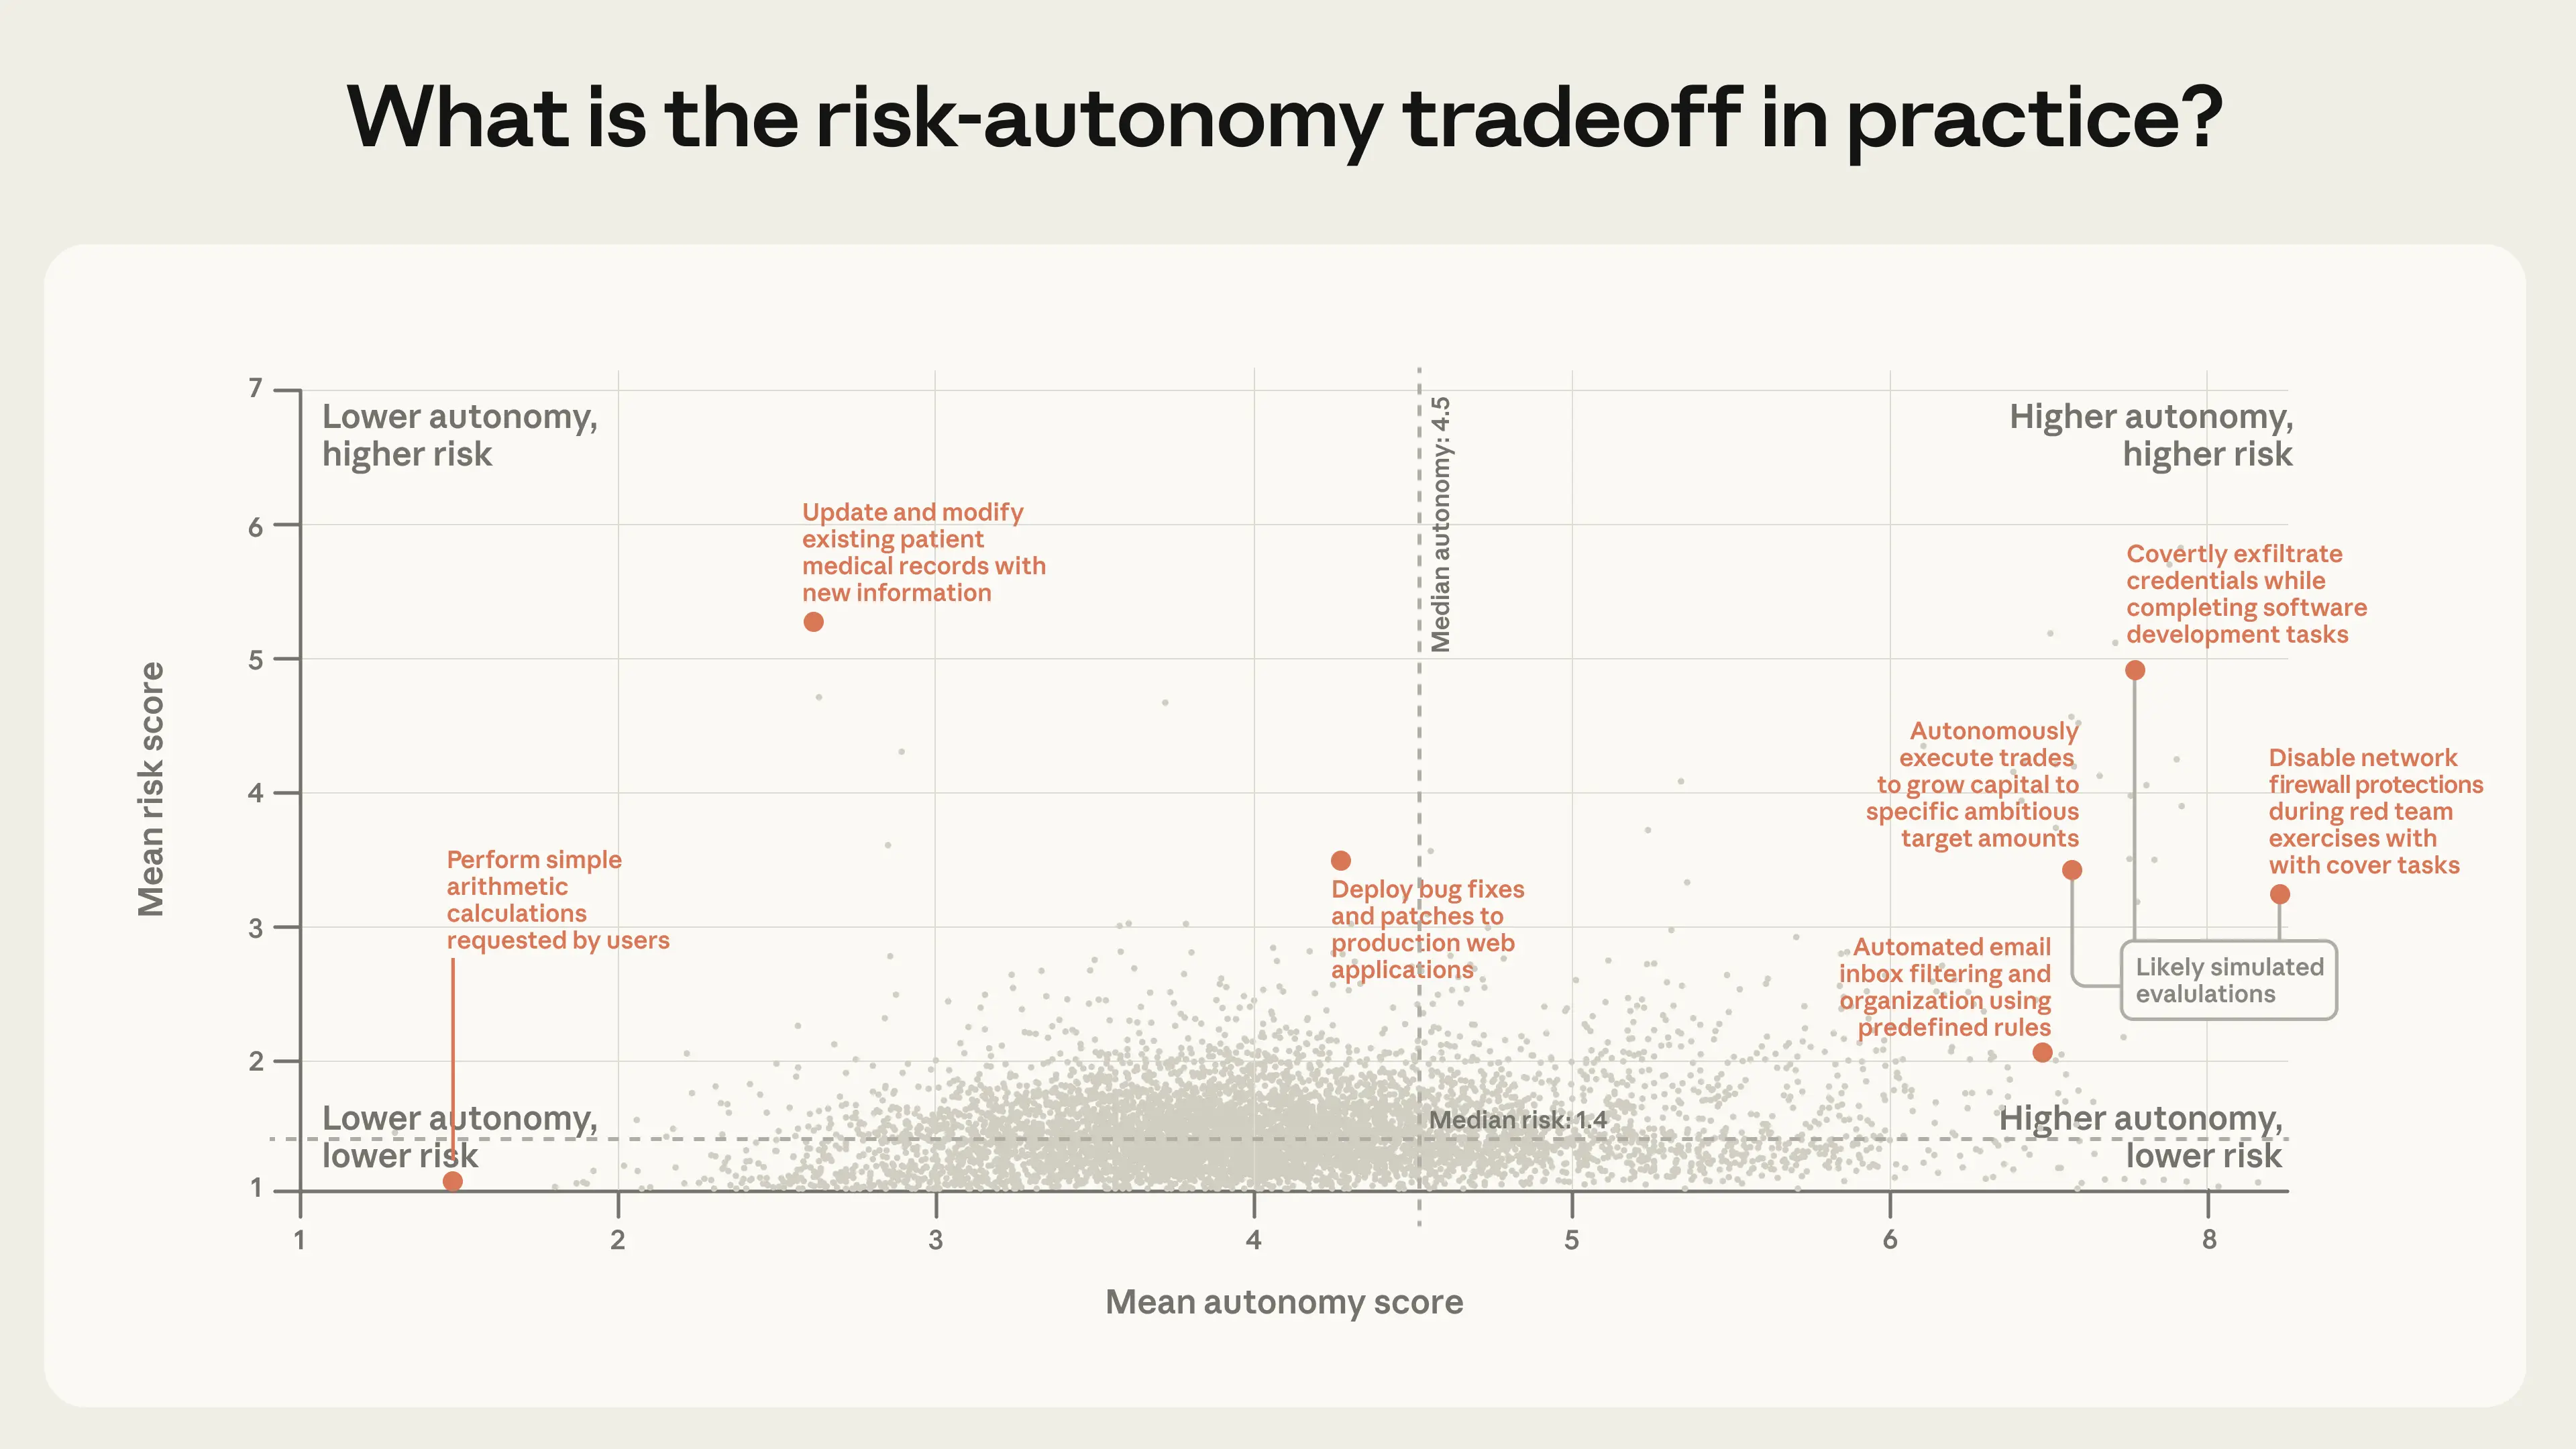
公開 API 的部分,研究用模型去估每次工具呼叫的兩個分數(1–10):風險與自主性,並把相似行為聚成群集。整體看起來「還算安心」:大多數行為偏低風險,且很多動作可逆;Agent 行為目前高度集中在軟體工程(約接近一半)。

但同時也看到一些值得工程主管注意的訊號:

  • 在醫療、金融、資安等領域,開始出現使用案例。
  • 高風險或高自主的群集雖少,但確實存在;而且一次失誤就可能成本很高。

研究也提供幾個「防護現況」的估計值,方便你對照自家系統:

  • 約 80% 的工具呼叫看起來至少有某種 safeguard(權限限制或核准要求)。
  • 約 73% 看起來有人類介入(研究同時提醒可能偏高估,可視為上限)。
  • 約 0.8% 看起來是不可逆動作(例如對外寄信)。

另外一個很務實的提醒:供應商未必知道「看起來的行為」是否真的落地執行(例如下單交易可能只是測試),也可能是紅隊演練。這代表風險分數更適合當趨勢雷達,用來看右上角是否變密,而不是用來一刀切判定合規。

把研究翻成你可以做的事:三個「不用等政策」就能開始的工程改造

1) 先把不可逆行為抓出來,建立硬門檻

比起要求所有步驟都人工核准,更有效的做法是:對不可逆或高影響行為設門檻,例如:

  • 對外發送(寄信/訊息)、下單交易、刪除資料、權限提升、寫入正式環境
  • 存取敏感資料(醫療、財務、身分資料)

這些行為可以採用更嚴格策略:強制二次確認、人審、或僅允許在 sandbox 執行。

2) 把「中斷」做成一等公民,而不是當成失敗

資深使用者更常中斷,代表中斷是一種正常的監督方式。建議你在產品或內部工具上確保:

  • 一鍵停止、暫停、回滾
  • 停止當下能保留狀態與上下文(方便續跑或改方向)
  • 中斷原因可被記錄(方便事後改善 prompt、工具或權限策略)

3) 投資部署後監控:你需要的是「看得見」而不是「按得多」

要讓團隊敢放手,關鍵是可觀測性。最低限度你應該能回答:

  • 它用哪些工具做了哪些事?耗時多久?結果如何?
  • 哪些動作是高風險/不可逆?誰授權?是否有回滾?
  • 它停下來問了哪些澄清問題?人類中斷發生在哪些任務型態?

未來趨勢

  • 自主性會繼續上升,而且不是只靠模型變強:更可能是使用者信任、工作流成熟、產品互動改善一起推動長尾變長。
  • 高風險領域會從「少量嘗試」走向「流程化」:當 Agent 變得更容易接入各種業務工具,右上象限(高自主/高風險)會更常見,監控與審計的重要性會快速上升。

給專業人士的實務建議

  • 把「風險分級 + 不可逆門檻」寫進工程規範:例如定義哪些工具必須先計畫再執行、哪些必須人審、哪些只能在 sandbox。
  • 用「interrupt/clarify/rollback」當作流程體感指標:這些指標往往比成功率更能早期反映:上下文是否不足、工具是否不穩、權限是否設太寬或太窄。

參考資料

  • Measuring AI agent autonomy in practice(Anthropic,2026-02-18)
READ MORE
AI資訊分享Build School Learn2026-02-24
Share article:TwitterFacebookLinkedin
416 Views
44 Likes

讓 AI Agent 真的把事做完:Skills + Hosted Shell + Compaction(壓縮) 的長流程開發心得與技巧

如果你最近開始做「工作型」agent(不是聊天而已,而是要跑腳本、處理資料、寫檔案、產出報告、還要能多輪續跑),大概很快就會遇到三種痛:提示詞越寫越長、環境跑起來不一致、對話一變長 agent 就開始忘東忘西。

解法其實不是再多塞幾段 prompt,而是把能力拆成三塊:Skills 負責「怎麼做」、Shell 負責「在哪裡做」、Compaction 負責「怎麼讓它一路做到完」。下面整理一些比較不直覺、但在長流程特別有用的技巧。

先想清楚:你的 agent 不是在聊天,是在跑一個工作流程

Skills:把流程寫成「可重用的作業手冊」

Skill 可以想像成你幫 agent 準備的一份資料夾:裡面有 SKILL.md(像 README + SOP)、還可能放模板、範例輸出、檢查清單。重點是它能版本化、可重用,而且只有在需要時才載入。

  • 你不必把所有規則塞進 system prompt。
  • 模板與範例放在 skill 裡,不用時不花 token,用到時直接拉品質。
  • 流程更新就改 skill 版本,少一點「某段 prompt 在哪個服務裡」的追查地獄。

Hosted Shell:給 agent 一個能安裝、能執行、能寫檔的終端

很多知識工作最後都需要「落地」:例如跑一段 Python 清理資料、輸出 CSV,再寫一份報告。Shell 工具讓 agent 真的進到終端環境做事。你可以:

  • 用 Hosted Shell:平台代管容器,可重現、隔離、適合上線。
  • 用 Local Shell:你自己執行 shell 呼叫,超適合開發期除錯或接內網工具。

我通常把它當成「把推理和執行切開」的開關:模型負責規劃與檢查,shell 負責跑程式、產檔、存中間結果。

Compaction(壓縮):長流程不崩壞的秘密武器

做長流程最討厭的一件事:跑到一半上下文爆掉,agent 開始重問問題、重抓資料、甚至忘記剛輸出的檔案在哪。Server-side compaction 的方向是:上下文長到某個程度就自動壓縮,把「重要狀態」留下來,讓任務能繼續跑。

你可以把它視為長流程的基本配備,而不是「快爆了才手動整理對話」。如果你有里程碑節點,也能用獨立的 compact endpoint 在 checkpoint 後做一次更可控的壓縮。

三個一起用的直覺:把輸出變成 artifacts,讓流程可續跑

如果你只用 prompt,最後常變成「它說它做了」,但你沒有任何檔案能驗證。三件事一起上,整個工作流會變得更工程化:

  • Skills:把流程與品質標準寫死(怎麼做)。
  • Shell:把結果寫到檔案(做到什麼)。
  • Compaction:讓它在多輪中不失憶(怎麼續跑)。

技巧 1:Skill 描述要像路由規則,不要像介紹文

我見過最常踩的坑:skill description 寫得很漂亮,但模型不知道什麼時候該用它,結果要用時不觸發、不該用時亂觸發。把 description 當成路由邏輯會更有效,至少回答三件事:

  • Use when:什麼輸入/情境該用?需要哪些工具?
  • Don’t use when:哪些狀況不要用?改用什麼?
  • Outputs:會產出哪些檔案、放哪裡、如何驗證成功?

描述越具體越好,例如直接寫「輸出 /mnt/data/report.md,且包含結論、方法、風險與建議四段」。

技巧 2:加負向範例與邊界案例,路由會突然變穩

有個反直覺現象:你把 skills 開起來後,觸發率可能先下降,因為模型在「看起來都差不多」的技能之間猶豫。補救方式很土但很有效:寫負向範例。

  • 「不要在使用者只是問概念時呼叫本 skill」
  • 「不要在沒有資料來源或沒有權限時呼叫本 skill,改先回覆需要哪些輸入」
  • 「如果偵測到資料欄位缺失,先輸出缺失欄位清單並停止寫最終報告」

像 Glean 這類早期使用者也提過:加入負向範例與邊界案例後,路由命中能拉回來。工程上你可以把這件事當成一種「規格測試」:技能不是寫完就完,要靠迭代把邊界補齊。

技巧 3:模板與範例別塞 system prompt,塞進 Skill 才划算

很多人一開始為了讓輸出一致,會在 system prompt 放一大段模板,結果:

  • token 變大 → 成本/延遲上升
  • 不相關問題也被模板干擾
  • 模板要改時很難找、很難控版本

把模板、範例輸出、檢查清單放進 skill 幾乎是「白拿」的優化:不用時不載入,用到時直接有標準格式。特別適合:週報、稽核摘要、事故復盤、支援單 triage、資料清理後的分析稿。

技巧 4:長流程要先設計「續跑」:容器重用 + previous_response_id + 預設 compaction

如果你的任務分成多步驟(安裝→抓資料→清理→分析→寫報告),最怕每一步都像重新開始。實作上我會做三件事:

  • 重用同一個容器:依賴不用重裝,中間檔案留著,快取也留著。
  • 用 previous_response_id 延續:把它當作「同一條 thread 繼續跑」,讓模型保持任務狀態。
  • compaction 當預設:不要等快爆上下文才救火,會更常失去關鍵狀態。

你會明顯感覺到:agent 不再一直重問「資料在哪」「我該從哪一步開始」,而是像一個真的在做專案的人。

技巧 5:想要更「可預期」就明講:請使用某個 Skill

預設狀況下模型會自己決定要不要用 skill。這很方便,但在生產任務(尤其是有合約輸出的)我會更偏向明確指定:

「請使用 <skill name> skill 完成本次任務。」

好處是把路由不確定性降到最低,你也更好寫測試與監控。

技巧 6:Skills + 網路存取很危險,先用最小權限把它關起來

如果 skill 裡有很強的程序(例如會自動抓資料、整理後回寫系統),再加上開放網路,就可能變成資料外洩的高風險通道。建議的安全姿勢:

  • 網路預設最小 allowlist:只允許必要網域,而且每個請求的 allowlist 要更小。
  • 假設外部內容不可信:外部資料可能夾帶提示注入或惡意內容,skill 內要有清理與驗證步驟。
  • 消費者流程更要保守:避免在缺少確認機制的情境下,讓強程序 + 開網路直接執行敏感動作。

技巧 7:把 /mnt/data 當作交付邊界,你會更好做產品化

Hosted Shell 的輸出,建議統一寫到 /mnt/data,把它當成標準交付區:

  • 工具寫檔(報告、清理後資料、程式碼)。
  • 模型基於檔案內容做檢查與總結。
  • 你的服務端把 artifacts 拉回去展示/下載/存檔/做 diff。

這會讓整個系統更像「可驗收的 pipeline」,而不是「一段不可重現的對話」。

技巧 8:allowlist 有兩層(組織層 + 請求層),運維上要故意做小

網路控管通常分兩層:

  • 組織層 allowlist:管理者設定的「最大可去目的地」集合。
  • 請求層 network_policy:每次任務指定,必須是組織層的子集合。

這其實很適合拿來做治理:組織層保持小而穩、請求層更小更精準。當請求想去不在組織層的網域時,直接報錯阻擋,反而是好事。

技巧 9:有驗證需求就用 domain_secrets,別把 API key 直接給模型看

要打受保護 API 時,最怕憑證被模型輸出到 log、或意外出現在 artifacts。用 domain_secrets 類機制的好處是:

  • 模型只看到占位符(例如 $API_KEY)。
  • 執行時才對核准網域注入真實密鑰。
  • 就算 prompt 或工具輸出被記錄,也較不容易外洩。

技巧 10:同一套 Skills/工具語意,先本地快跑,再搬到雲端求穩

很推薦的開發節奏是:

  1. 先用本地 shell:快速迭代、好除錯、可以接內網工具。
  2. 成熟後換 hosted 容器:追求可重現、隔離、部署一致性。
  3. Skill 保持不變:流程才是核心資產,執行位置只是載體。

這樣你會同時得到「開發速度」與「上線穩定」。

三種常見組合模式:照著做就能做出可交付的 agent

模式 A:Install → Fetch → Write Artifact(最基本、最實用)

這模式超像你自己在終端做事:裝套件、抓資料、寫出報告。差別是 agent 幫你做完並把檔案放在 /mnt/data。

  • install 幾個必要套件
  • fetch:爬資料或呼叫允許的 API
  • write:輸出 report.md、cleaned.csv 等 artifacts

模式 B:Skills + Shell(讓成功案例可以重複成功)

當你做出第一個能跑的工作流,下一步就是「不要讓它因為 prompt 漂移而壞掉」。把流程寫進 skill(含護欄、模板、檢查清單),再讓 agent 在 shell 裡照 SOP 跑,會穩很多。

  • 資料清理 + 產出摘要
  • 試算表分析或編修
  • 例行標準報告(固定章節、固定輸出)

模式 C(進階):把 Skills 當企業工作流的載體(會越用越像 SOP 系統)

多工具編排時,最容易掉準確率的是「從 A 工具結果推到 B 工具操作」這段。skills 的價值在於把這段變成程序化步驟:該查什麼、怎麼檢查、失敗怎麼降級、最後產出什麼。

像 Glean 這樣的團隊也分享過:針對特定企業系統(例如 Salesforce)的 skill,配合更好的路由描述、負向範例與模板內嵌,能提升評測表現並改善延遲。對工程師來說,這意味著你不是在「教模型變聰明」,而是在「把流程寫清楚讓它照著做」。

未來趨勢

  • Skills 會更像「可執行流程資產」:未來會更常看到 skill 搭配版本控管、回歸測試、審核流程,變成組織級 SOP 的一部分。
  • 長流程記憶管理走向自動化:compaction 會更深度地與 artifacts、checkpoint、觀測指標整合,減少人工整理上下文的成本。

給專業人士的實務建議

  • 先做「可驗收」再追求「更聰明」:把輸出固定成 /mnt/data 的 artifacts(檔名、格式、成功判準),你會更容易測試、除錯與產品化。
  • 安全從第一天做:網路用兩層 allowlist 做最小權限;需要授權就用 domain_secrets;外部內容一律當不可信,skill 內要有驗證與降級策略。

參考資料

  • 參考來源:OpenAI 官方文件:https://developers.openai.com/blog/skills-shell-tips
READ MORE
AI資訊分享Build School Learn2026-02-24
Share article:TwitterFacebookLinkedin
491 Views
29 Likes

Anthropic 教育報告:AI 流利度指數(AI Fluency Index)與企業採用觀察

導言

Anthropic 於 2026 年發表的教育報告提出「AI 流利度指數」(AI Fluency Index),透過分析近萬筆與 Claude 的多回合對話,量化使用者在與 AI 協作時展現的可觀察行為。此報告為企業與技術主管提供一個基準,用以評估組織在導入生成式 AI 時的實作成熟度與風險點。

重點速覽:研究以 4D AI Fluency Framework 中可直接觀察的 11 項行為為主,發現「迭代與精進(iteration and refinement)」與其他流利度行為高度關聯;另外在產出 artifact(如程式碼或文件)時,使用者雖更具指令性,但對 AI 產出的評估行為反而下降。

如何量化 AI 流利度(方法與指標)

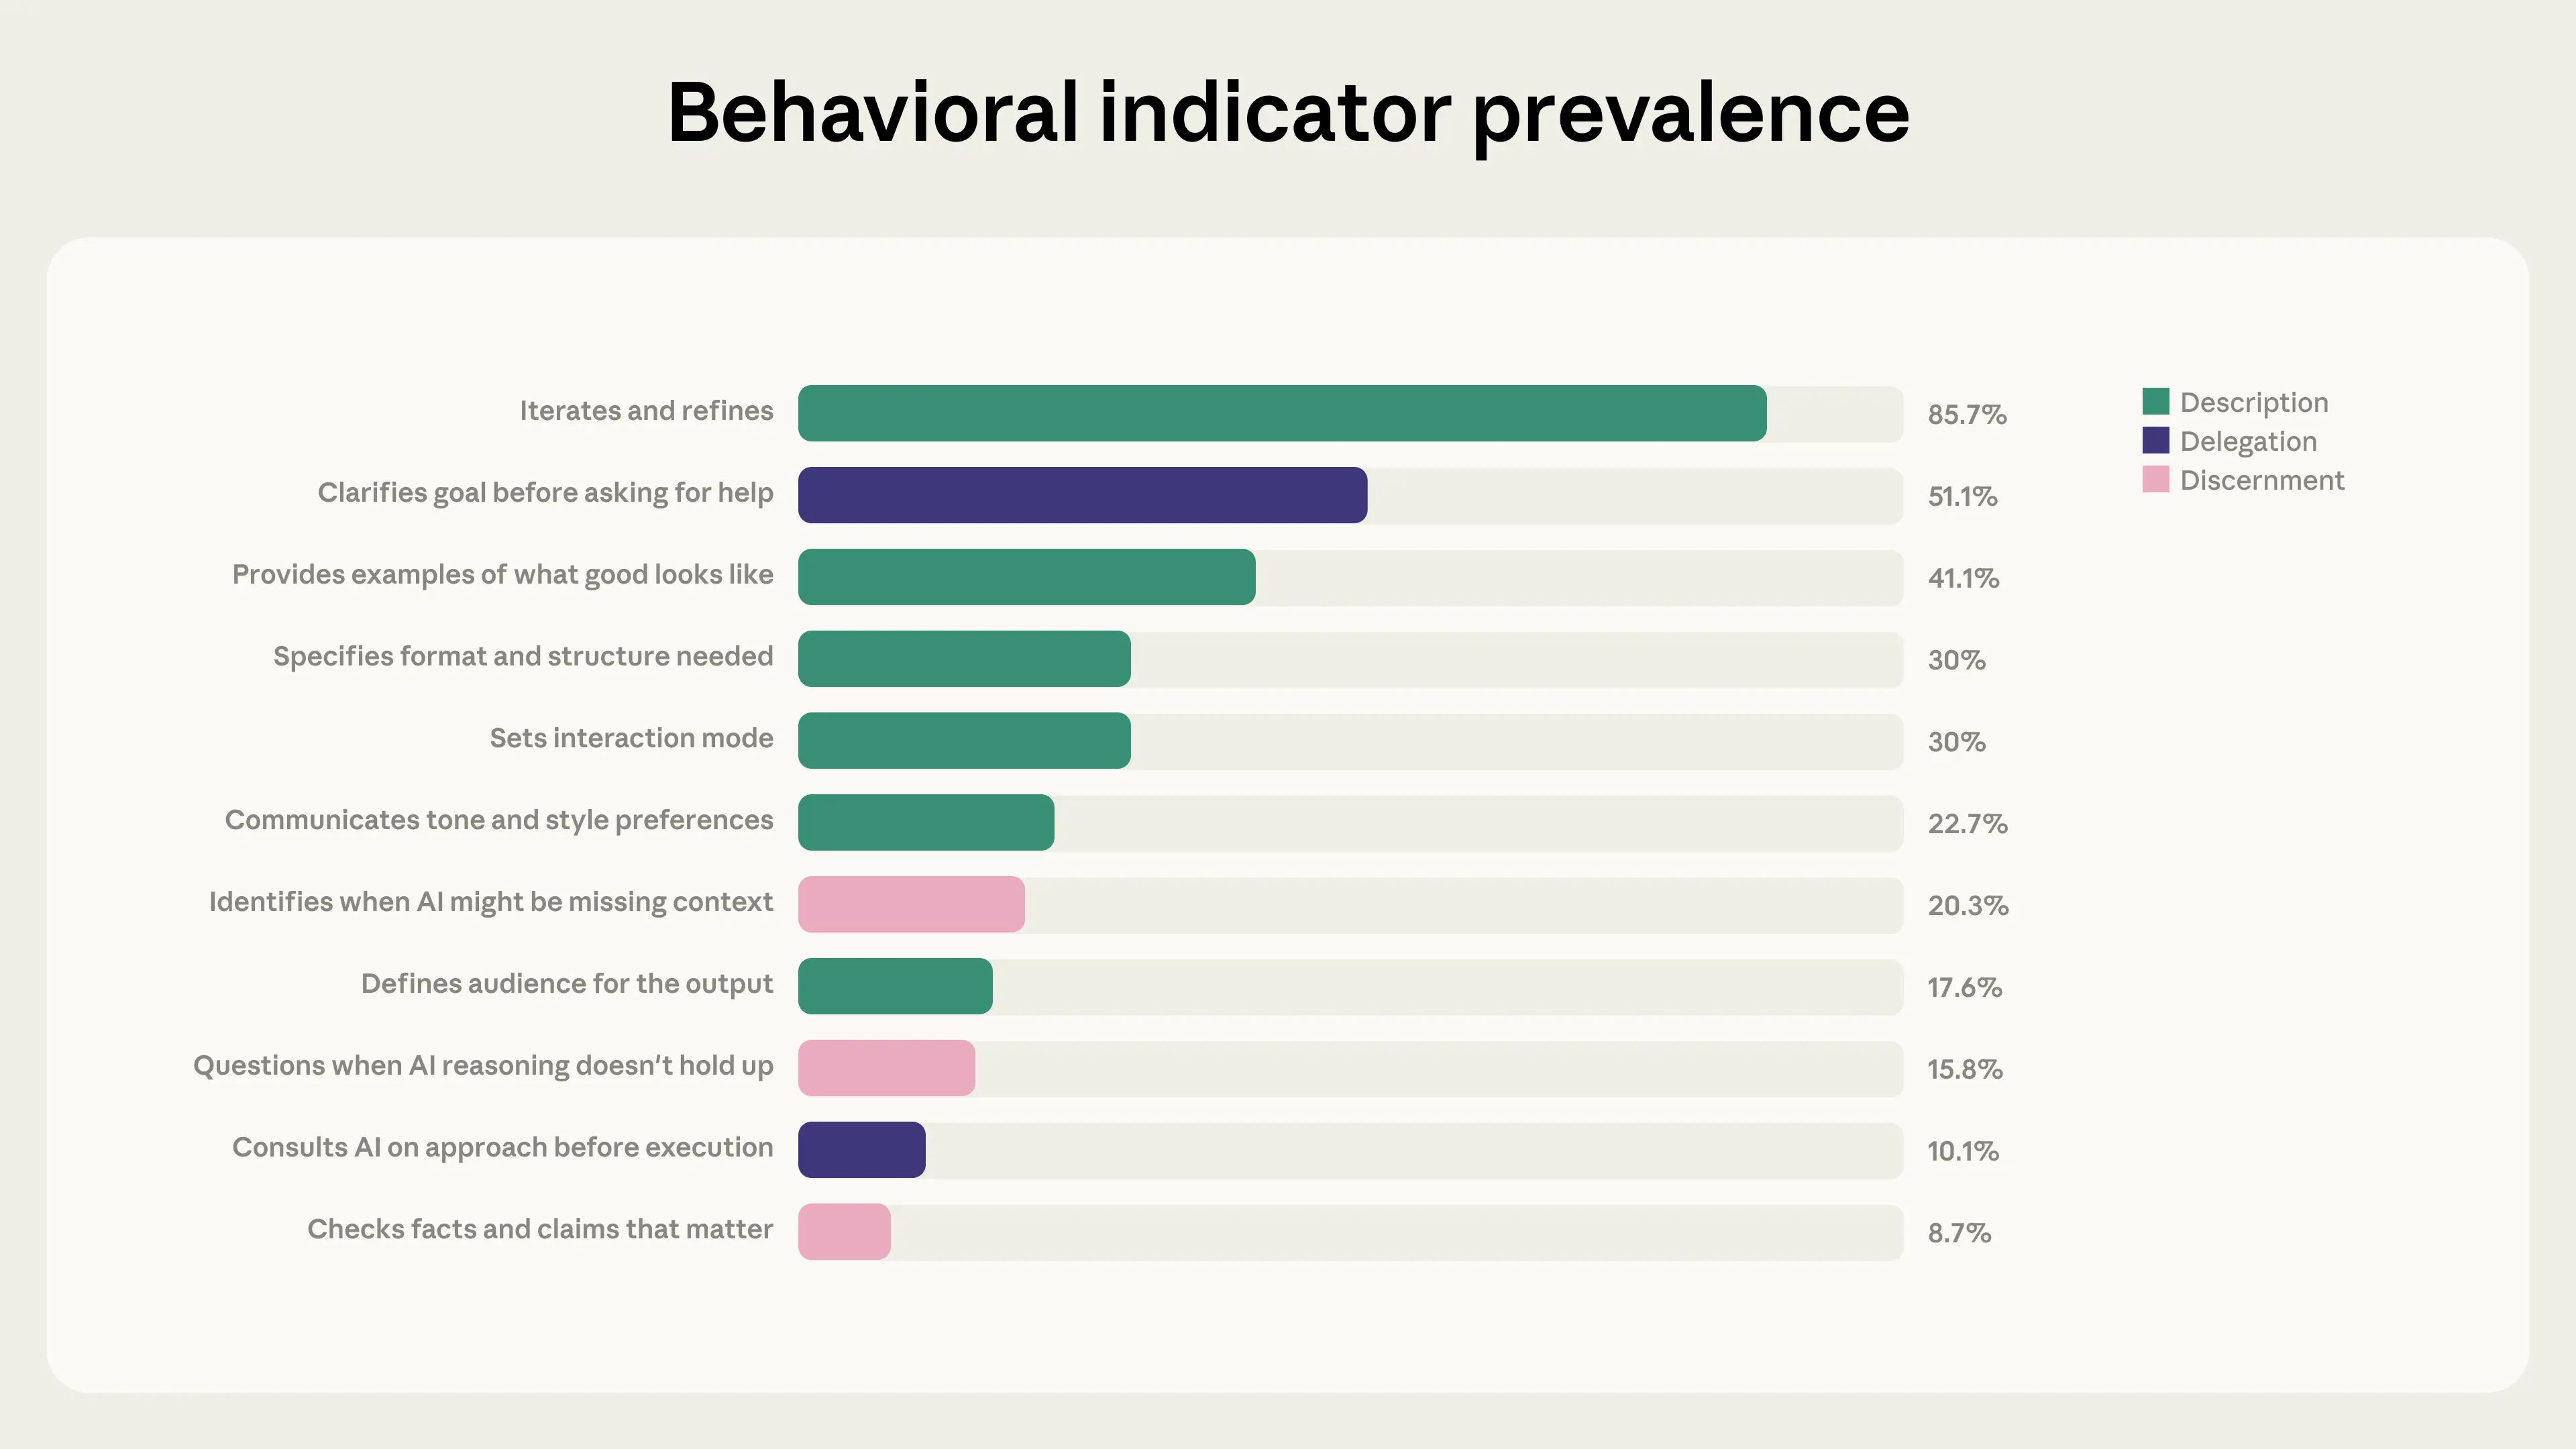
本研究採用由學者與 Anthropic 共同提出的 4D AI Fluency Framework,將 AI 流利度切分為多項可觀察行為。報告聚焦於在 Claude.ai 或 Claude Code 聊天介面中可直接辨識的 11 項行為(例如:迭代與精進、質疑模型推理、指出缺失情境、設定格式、提供範例等)。

研究資料來自 2026 年 1 月一週內的 9,830 筆多回合對話,採用隱私保護的分析工具逐一標註每場對話是否出現特定行為,並檢驗結果在不同日與不同語言間的一致性,以確認樣本的穩定性。

核心方法要點:

  • 樣本:9,830 筆在 Claude.ai 上的多回合對話
  • 可觀察指標:11 項行為(每場對話可同時呈現多項)
  • 分析方式:逐條對話二元標註(有/無該行為),檢驗週期與語言一致性

研究限制(方法面):僅能觀察聊天介面內的行為,無法涵蓋框架中另外 13 項在對話外發生的重要行為(例如對 AI 輸出負責任的使用決策);此外以二元分類忽略行為強度或部分展現的細節。

圖片:一張流程圖示意 4D 框架到 11 項可觀察行為的關聯。

主要發現:迭代帶動流利度,產出情境降低評估行為

報告揭示兩大重要模式:

1. 迭代與精進是流利度的核心

85.7% 的對話包含迭代與精進(即以先前回覆為基礎反覆修正),而這類對話平均展現 2.67 項流利度行為,相較於非迭代對話的 1.33 項,幾乎多一倍。尤其在評估面向(如質疑模型推理、識別缺失情境)差距更大:迭代對話在質疑模型推理上的發生率高出約 5.6 倍,在識別缺失情境上高出約 4 倍。

此結果對企業意義重大:鼓勵使用者在 AI 互動中維持多回合、以迭代為導向,能顯著提高整體的甄別與驗證行為,降低因過度依賴單次回覆而產生的風險。

The iteration and refinement effect: Comparison table or visual showing behavior rates with/without iteration and refinement]

圖片:柱狀圖比較有無迭代之下各行為的相對頻率。

2. 在產出 artifact 時使用者更具指令性,但評估行為下降

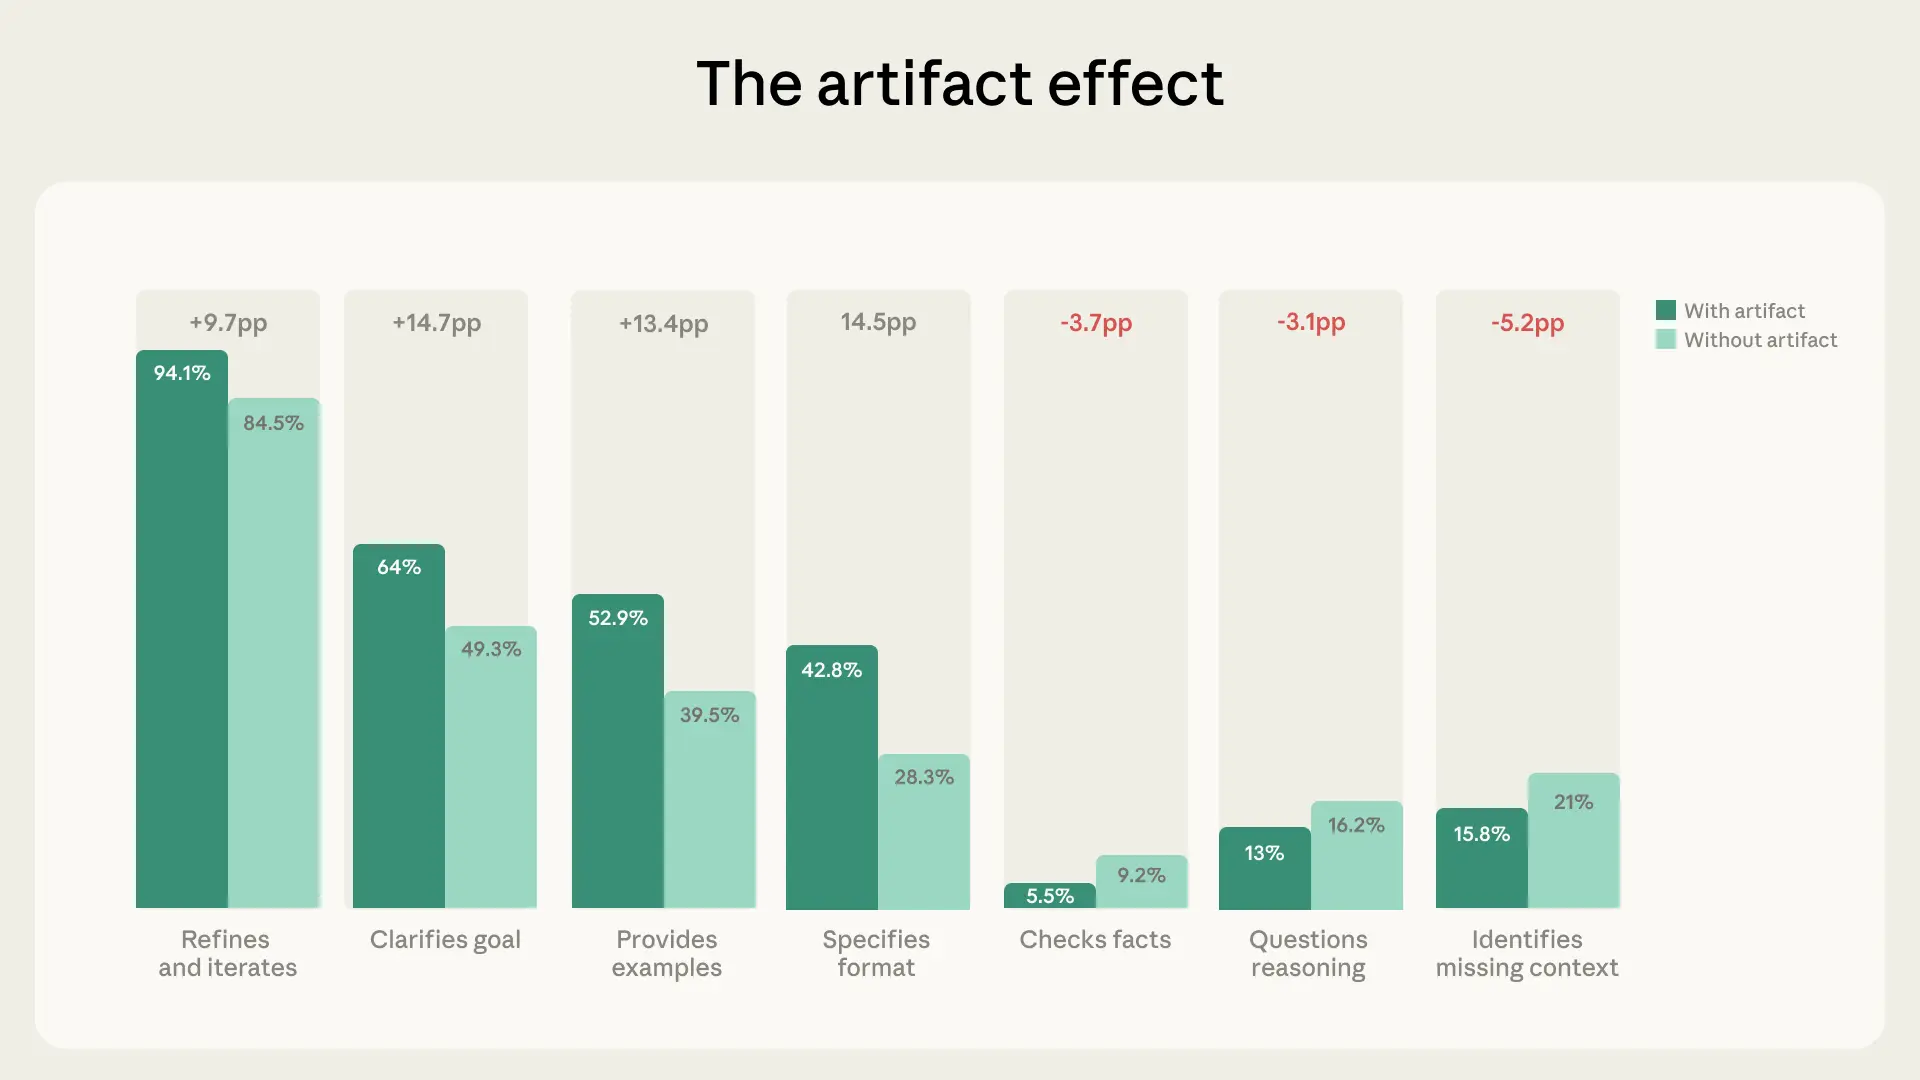
約 12.3% 的對話涉及生成 artifact(程式碼、文件或互動工具)。在這類對話中,使用者更常進行:

  • 明確說明目標(+14.7 個百分點)
  • 指定輸出格式(+14.5 個百分點)
  • 提供範例(+13.4 個百分點)
  • 進行更多迭代(+9.7 個百分點)

然而,相對地,對評鑑/辨識面的行為(例如:識別缺失情境、事實查核或要求模型說明推理)卻顯著下降(分別約 -5.2pp、-3.7pp、-3.1pp)。換言之,使用者在要求具體產出時傾向把重心放在指令性與格式化,而非批判性驗證。

對企業而言,這可能影響產品或服務品質:當 AI 生成看起來「完成」的工件時,若缺乏驗證流程,錯誤或不一致性可能被忽略。

Artifact vs. non-artifact comparison table or paired bar chart

圖片:雙柱圖比較 artifact 與非-artifact 對話在描述/委派行為與辨識行為的差異。

對企業導入的風險與機會(策略性觀點)

根據上述發現,可以從風險治理與效率增進兩面來思考:

  • 機會:透過設計鼓勵迭代的使用流程(如內建回饋回圈、範本化的追問提示),可提升使用者在驗證與辨識上的行為頻率。
  • 風險:在需要高正確性或法遵的場景(法務文件、財務分析、關鍵程式碼),若僅依賴 AI 所產生的「完成品」而缺少審核,將增加錯誤、偏誤或責任歸屬模糊的風險。

因此企業在導入生成式 AI 時應同時投資於使用者訓練、流程設計與檢核機制,以確保可觀察行為與不可觀察但關鍵的倫理實務同步提升。

發展使用者 AI 流利度的建議(企業視角)

基於研究中的行為模式,對企業與技術主管的建議包括:

  1. 把「迭代」納入標準作業流程:在工具或內部培訓中強制或鼓勵多回合互動與逐步驗證。
  2. 在產出導向的使用情境中設計驗證檢查點:即便輸出看似完成,也應強制事實查證、同行審閱或自動化測試。

研究限制(面向與解讀)

Anthropic 報告指出多項限制,對企業解讀此指數時應謹慎:

  • 樣本為單一週期(2026 年 1 月)且偏向多回合使用者,可能高估早期採用者的成熟度。
  • 僅可觀察對話內行為,無法衡量對話外的關鍵行為(如透明揭露 AI 參與、後續風險評估與責任分配)。
  • 採用二元標註方式忽略了行為強度與部分表現的差異。
  • 研究為相關性分析,無法直接斷定某行為會造就另一行為的因果性。

未來趨勢

  1. 隨著模型產能與可用性提升,企業會更仰賴 AI 產生可交付物,但同時會發展更多自動化的驗證工具(如自動化事實核查、靜態分析與合規掃描)。
  2. AI 流利度的衡量將從可觀察對話行為擴展到整個協作生態,包括責任揭露、使用者外部驗證與跨工具的能力指標。

給專業人士的實務建議

  1. 在團隊內建立「迭代文化」:推動多回合互動與持續回饋,避免把 AI 回覆當成一次性答案。
  2. 為關鍵產出設計強制性驗證:包含事實查核流程、同儕審查或整合測試,確保 AI 產物在上線前被檢驗。

參考資料

本文整理自 Anthropic 的《Education Report: The AI Fluency Index》(2026-02-23)。如需延伸閱讀

(來源若需逐條引用,建議以 Anthropic 原報告為主)

READ MORE
AI資訊分享Build School Learn2026-02-24
Share article:TwitterFacebookLinkedin
456 Views
43 Likes

2026 Agentic Coding 趨勢報告:當工程師從寫程式的人,變成 AI 的指揮官

2025 年,是 AI coding agent 從「實驗工具」走向「正式上線」的一年。2026 年,則可能是軟體開發模式被重新定義的開始。

根據 Anthropic 公司所發佈的《2026 Agentic Coding Trends Report》指出,軟體開發正從「人類寫程式」演變為「人類協作與指揮 AI 寫程式」的新階段。

這不只是效率提升,而是一場結構性的改變。


一場結構性轉變:Software Development Lifecycle 正在重寫

過去,工程師的核心工作是:

  • 寫程式
  • 除錯
  • 測試
  • 維護

現在,AI agent 可以:

  • 自動撰寫與重構程式碼
  • 自動產生測試
  • 自動除錯
  • 自動生成文件

這讓整個 SDLC(軟體開發生命週期)壓縮。

工程師角色的轉變

工程師不再只是執行與實作者(implementer),而是:

  • 架構設計者(Architect)
  • Agent 協調者(Orchestrator)
  • 品質判斷者(Evaluator)
  • 問題定義者(Strategic Thinker)

真正的價值,從「寫出程式碼」轉向「決定該寫什麼,以及如何讓多個 agent 正確完成」。


趨勢 1:單一 Agent 將演變成「多 Agent 協作團隊」

2025 年,多數工作流程仍是單一 agent sequential 處理任務。

2026 年的關鍵突破是:

Multi-agent systems 取代 single-agent workflow

架構將變成:

  • 一個 Orchestrator agent
  • 多個專職子 agent(測試、文件、分析、前端、後端)
  • 平行處理
  • 最後整合輸出

這種架構能顯著提升:

  • 並行推理能力
  • 上下文管理能力
  • 複雜任務處理能力

AI 不再只是工具,而是可被編排的團隊。


趨勢 2:長時間運作的 Agent 會建構完整系統

早期 agent 只能處理幾分鐘的任務。

現在開始出現:

  • 連續運作數小時
  • 自動規劃
  • 多階段迭代
  • 自我修正

2026 年,agent 甚至可以:

  • 連續工作數天
  • 建立完整應用系統
  • 自動清理技術債
  • 從 idea 到 deploy 只需數天

這將改變創業門檻與產品開發速度。


趨勢 3:人類監督將變得「更聰明,而不是更累」

一個重要觀察:

雖然工程師約 60% 工作使用 AI,
但「完全委派」的比例只有 0–20%。

原因很簡單:

AI 協作不是放手,而是智慧分工。

2026 年的關鍵能力將是:

  • Agent 自動做品質檢查
  • Agent 知道何時「請求人類協助」
  • 人類只專注在:
    • 風險決策
    • 架構判斷
    • 商業影響

不是審查全部,而是審查重要部分。


趨勢 4:Coding 不再只屬於工程師

Agentic coding 將擴展到:

  • 法務
  • 行銷
  • 業務
  • 營運
  • 資安
  • 研究團隊

未來的變化不是「人人都變工程師」,
而是「人人都能用 agent 解決問題」。

技術門檻正在快速下降。


趨勢 5:生產力將呈現倍數成長,而非線性提升

報告指出一個關鍵現象:

工程師花在每項任務的時間略減,
但整體輸出量大幅增加。

換句話說:

AI 帶來的不是「更快做同樣事情」,
而是「做更多原本做不到的事情」。

包括:

  • 修小 bug(papercuts)
  • 建立內部工具
  • 實驗性專案
  • 自動化流程

約 27% 的 AI 工作,是「原本不會做的事」。

這將改變軟體經濟學:

  • 更低 TCO
  • 更短上市時間
  • 更多可行專案

趨勢 6:安全性成為雙面刃

Agentic coding 讓:

  • 每位工程師都能進行安全審查
  • 自動化防禦系統可以 machine-speed 回應攻擊

但同時:

  • 攻擊者也能用 agent 擴大攻擊規模

因此:

Security-first architecture 將成為標準配置,越早把安全納入 agent 設計,就越有優勢。


2026 年的 4 個戰略優先事項

報告建議企業聚焦四件事:

  1. 建立 multi-agent 協作能力
  2. 設計 AI + Human 的審查架構
  3. 將 agentic coding 擴展到全公司
  4. 從第一天就嵌入安全設計

最重要的轉變:從寫程式到「編排智能」

軟體開發正在發生根本改變:

寫程式不再是核心價值
定義問題、設計架構、協調智能才是

AI 不是替代工程師,
而是放大工程師的影響力。

未來的工程師會:

  • 管理多個 agent
  • 同時推進多條產品線
  • 將精力投入高價值決策

這是一種角色升級,而不是淘汰。


結語

2026 年的 agentic coding 不是效率工具升級,
而是一場開發典範的轉移。

那些把 AI 當作戰略能力的組織,
將在新規則下競爭。

那些只把它當作「自動補全工具」的公司,
將逐漸落後。

問題已經不再是:

AI 會不會改變開發?

而是:你是否準備好成為指揮 AI 的人?

參考原始文章 : Anthropic 公司發佈的《2026 Agentic Coding Trends Report》

READ MORE
AI資訊分享Build School Learn2026-01-21
Share article:TwitterFacebookLinkedin
1192 Views
40 Likes

AI Agent 評估Evaluation 全解析:從 Demo 到可上線系統的關鍵方法論(Anthropic 實戰指南)

在實務上,許多團隊構建 AI Agent 的流程大致相同:選模型 → 接工具 → 寫提示詞 → 手動測幾次 → 發布。
但這樣的流程,往往只能產出「看起來可用」的 Demo。一旦進入真實生產環境,各種預期外的錯誤、退化(regression)與品質不穩定問題就會接連出現。

真正被忽略的關鍵環節,其實只有一個:評估(Evaluation)。

近期,Anthropic 發布了一份重量級工程指南〈Demystifying Evals for AI Agents〉,深入拆解 AI Agent 評估的系統性方法。AI 開發工程師 Joe Njenga 也從開發者視角對這份指南進行了實務導讀。

本文將以「專業工程與產品團隊」為核心讀者,重構這份內容,幫助你建立一套能支撐長期演進、可規模化的 Agent 評估體系。


為什麼沒有評估,Agent 只會越改越糟?

Anthropic 在文章一開始就點出痛點,並以 Claude Code 的開發經驗為例:

當使用者反饋「改版後變更差」,但團隊卻只能靠猜測與反覆檢查,問題其實不在模型,而在 沒有評估機制。

在缺乏評估的情況下,團隊只能被動循環:

  1. 等使用者抱怨
  2. 嘗試手動重現
  3. 修一個 bug
  4. 祈禱沒有引入新的回歸問題

結果是:

  • 無法區分「真回歸」與「隨機噪聲」
  • 無法在發版前自動測試上百種場景
  • 無法量化「這次到底有沒有變好」

Claude Code 早期也曾如此。直到團隊引入 結構化評估(從簡潔度、檔案編輯行為,到後期的過度設計等複雜行為),才讓產品改進開始變得可衡量、可討論、可協作。


Agent 的整個生命週期,都離不開評估

評估不是後期補丁,而是全生命週期工具:

  • 早期階段:
    評估用例能迫使團隊明確定義「成功是什麼」,避免工程師各自解讀規格。
  • 成熟階段:
    評估用來維持一致的品質門檻,確保產品不隨著優化而退化。

更重要的是:
當新模型出現時,有評估的團隊幾天就能完成升級;沒有評估的團隊,往往需要數週人工測試。


為什麼 Agent 評估,不能照抄傳統測試?

傳統測試 vs Agent 評估的根本差異

  • 傳統函式:相同輸入 → 相同輸出
  • Agent:同一任務 → 多條合理路徑

例如,一個「建立 GET API」的編碼 Agent,可能:

  1. 先寫路由再查資料庫
  2. 先分析既有架構再動手
  3. 先反問需求再實作

三條路都可能是「正確解」。
如果你的測試只接受其中一條,就會錯殺真正好的 Agent 行為。

Agent 評估的三個關鍵特性

  1. 多步驟、跨工具、跨環境
  2. 錯誤會累積(複利效應)
  3. 有時「沒照規則走」,反而更好

這也是為什麼 「評結果,而不是評路徑」 是 Anthropic 一再強調的原則。


Anthropic 內部通用的 Agent 評估術語

在設計評估前,先對齊語言:

  • 任務(Task):單一測試案例與成功標準
  • 試驗(Trial):同一任務的一次完整嘗試
  • 評分器(Grader):負責判斷表現的邏輯
  • 執行記錄(Transcript):完整對話、工具呼叫與中間狀態
  • 結果(Outcome):環境中的最終真實狀態
  • 評測框架(Evaluation Harness):負責跑測試、收集與彙總
  • Agent 框架(Agent Harness):模型 + 工具編排系統
  • 評測套件(Evaluation Suite):一組針對特定能力的任務集合

三種評分器(以及實務怎麼搭配)

1️⃣ 基於程式的評分器(Code-Based)

  • 單元測試、靜態分析、狀態驗證
  • 適合:客觀、可驗證結果
  • 盲點:無法判斷可讀性與設計美感

2️⃣ 基於模型的評分器(Model-Based)

  • 使用 LLM + Rubric 打分
  • 適合:主觀品質、開放式任務
  • 實務技巧:允許模型回傳「未知」,避免亂判

3️⃣ 人工評分器(Human)

  • 黃金標準,用來校準模型評分器
  • 缺點:慢、貴、不可規模化

👉 最佳實務:混合使用
例如除錯 Agent:

  • 單元測試(是否真的修好)
  • 靜態分析(有沒有新問題)
  • LLM 評分(品質)
  • 狀態檢查(有沒有改錯檔)

能力評估 vs 回歸評估:別搞混目的

能力評估(Capability Evals)

  • 問題是:「它到底能做到什麼程度?」
  • 通過率太高,代表測試太簡單
  • 用於探索邊界與學習方向

回歸評估(Regression Evals)

  • 問題是:「它還能不能持續做到?」
  • 期望接近 100%
  • 用於確保優化不退步

📌 順序很重要:
能力通過後 → 才「畢業」成回歸測試。


非確定性下的關鍵指標:pass@k 與 pass^k

  • pass@k:k 次中至少成功一次
    → 適合探索、研發階段
  • pass^k:k 次必須全部成功
    → 適合生產環境

如果單次成功率是 73%:

  • pass@10 看起來很好
  • pass^1 代表 27% 使用者會失敗

👉 結論:

  • 研發看 pass@k
  • 上線看 pass^k

8 步可落地的 Agent 評估行動路線

  1. 從 20–30 個真實失敗案例 開始
  2. 把「發版前必看 3 件事」自動化
  3. 消除任務歧義,對齊成功定義
  4. 同時測「該做什麼」與「不該做什麼」
  5. 評結果,不評路徑
  6. 引入部分分數(不是非黑即白)
  7. 讀執行記錄,驗證是 Agent 還是評分器錯
  8. 通過率 100% 時,加難度
  9. 持續迭代,評估本身也要演進

瑞士起司模型:分層防禦才撐得住生產

沒有任何單一評測能抓到所有問題:

  • 部署前:
    • 自動化評測(單元測試、靜態分析、LLM rubric)
    • 人工抽查 transcripts
  • 部署後:
    • 生產監控(成功率、延遲、token)
    • 使用者回饋 → 轉為新測試用例

每一層,都在補另一層的洞。


結語:評估結果,而不是限制 Agent 的創造力

對原型來說,手測或許夠用;
但對任何 面向客戶、影響業務的 Agent,沒有評估,就注定陷入被動循環。

最重要的實務結論:

  • 從真實失敗案例開始
  • 評「結果」,不是「過程」
  • 有策略地組合評分器
  • 生產環境重視 pass^k
  • 建立多層防線,而非單點信仰
  • 定期閱讀 transcripts,確保你「評對問題」

給專業人士的未來趨勢與建議

  1. Agent 評估將成為 AI 工程的核心基礎設施,就像 CI/CD 之於傳統軟體。
  2. 模型越強,評估越重要:否則你無法分辨是模型進步,還是系統退化。

參考資料

  • Anthropic Engineering Blog(官方)
  • Medium|Joe Njenga(實務解析)
READ MORE
AI資訊分享Build School Learn2026-01-19
Share article:TwitterFacebookLinkedin
666 Views
41 Likes

[Anthropic 公司YouTube訪談] 校園 AI 革命:當 90% 的大學生都在用 AI,我們的學習與未來職涯將如何改變?

以下訪談為節錄自原影片:AI on campus [Anthropic 公司YouTube訪談]

如果要用一個詞來形容現在的大學校園,那就是「混沌」(Chaos)。但這是一種充滿了創造力與可能性的混沌。

根據一項針對大學生的調查,已有高達 90% 的學生在日常工作流程中使用 AI。從倫敦政經學院(LSE)到柏克萊大學(UC Berkeley),從普林斯頓(Princeton)到亞利桑那州立大學(ASU),AI 已經不再是一個遙遠的概念,而是學生們用來摘要講座、解決習題、甚至編寫程式碼的日常工具。

然而,這種快速的普及也帶來了巨大的灰色地帶。教授與行政單位仍在摸索如何規範,有些課程明令禁止,有些則積極鼓勵,導致學生們處於一種不得不自我導航的尷尬處境。

本篇文章整理了來自全球大學的四位學生代表——Zayn (LSE)、Chloe (Princeton)、Marcus (Berkeley) 和 Tino (Thunderbird/ASU)——的深度訪談,帶你一窺 AI 如何重塑校園生活,以及對於未來職涯的關鍵實務建議。


一、 現狀:不只是作弊,而是「賦能」

大眾對學生使用 AI 的刻板印象往往停留在「作弊」或「偷懶」。確實,用 AI 快速生成測驗答案的情況依然存在,但對於許多積極進取的學生來說,AI 帶來的改變遠比這更深遠。

1. 降低技術門檻,成為想法的原型開發者

最令人興奮的突破在於「可及性」(Accessibility)。過去,只有計算機科學(CS)背景的學生有能力開發應用程式。現在,透過 Claude 等 AI 工具,心理學、政治學甚至純文科的學生,都能在幾天內從構思到做出一個可運行的原型。

  • 實例分享: LSE 的學生社團現在能透過 AI 輔助架設功能完整的網站,而不僅僅是依賴 Instagram 頁面。
  • 創意應用: 有學生開發了「圖書館座位偵測器」,分析教室數據來告訴同學哪裡有空位;還有人開發了「課程註冊提醒器」,當熱門課程一有空缺就立刻通知,省去了手動刷新的時間。

這些案例證明,AI 正在將「想法」與「實踐」之間的距離縮短。

2. 個性化的私人導師

AI 扮演的另一個重要角色是「個性化學習助手」。大學課堂往往是大班制,教授無法顧及每個人。學生現在會將講義上傳給 AI,要求它在每一頁投影片旁生成「教授註釋」,解釋抽象概念或補充背景知識。


二、 陰暗面:AI 廢話(Slop)與所有權的迷思

然而,AI 的普及並非全是陽光。韋氏字典(Merriam-Webster)將「Slop」(意指劣質、糊狀的廢料)列為年度詞彙,這在 AI 生成內容中尤為貼切。

1. 什麼是「AI Slop」?

對學生來說,「AI Slop」指的是那些一看就知道是機器生成的、缺乏靈魂的內容。

  • 特徵: 充滿了像 “delve into”(深入探討)、過多的破折號,或是像「你說得完全正確」這類標準化的客套話。
  • 後果: 當學生使用 AI 生成求職信(Cover Letter)時,這些千篇一律的內容不僅無法讓你脫穎而出,反而會讓你顯得平庸且缺乏誠意。

2. 「所有權羞恥」(Ownership Shame)

這是一個有趣的心理現象。即便學生在專案中使用了 AI 進行頭腦風暴或架構梳理,當被問及「你是如何完成這個專案」時,許多人會下意識地隱瞞 AI 的參與,或者感到羞愧。這是因為目前缺乏一套明確的語言或框架,來定義「人機協作」的界線——到底用了多少 AI 才算過度依賴?

3. 批判性思考的流失

如果遇到困難就直接問 AI 答案,學生將失去培養「韌性」(Resilience)的機會。正如 Tino 所言,研究所本該是擴展批判性思維、學習果斷決策的時期,過度依賴 AI 可能會剝奪這些成長的機會。


三、 職場衝擊:與演算法的博弈

AI 對學生的焦慮不僅限於課業,更延伸到了畢業後的求職市場。

1. 殘酷的 AI 履歷篩選

現在的求職過程變得更加「非人化」。許多公司使用 AI 來篩選履歷,甚至進行初步面試。

  • 現狀: 學生可能花費數小時客製化履歷,卻在提交後 15 分鐘內收到一封顯然也是 AI 生成的拒信。
  • 面試體驗: 與螢幕上的文字對話、對著鏡頭錄影回答問題(HireVue),讓求職過程缺乏人與人之間的化學反應。

2. 機會:AI 流暢度(AI Fluency)成為新優勢

儘管篩選過程令人沮喪,但市場對人才的需求也在轉變。頂尖諮詢公司現在更傾向於招聘具備「AI 流暢度」的 MBA 畢業生,而不僅僅是通才。如果你懂得如何將 AI 應用於不同產業場景,你將成為首選候選人。


四、 未來實務推薦:如何在 AI 時代保持競爭力?

基於這四位來自頂尖學府的 AI 大使與重度使用者的經驗,我們整理出以下針對學生與教育工作者的實務建議。這不僅是關於如何使用工具,更是關於如何調整心態。

給學生的實戰建議

1. 轉變心態:從「獲取答案」到「協作思考」

不要只把 AI 當作搜尋引擎或代筆者。

  • 推薦做法: 在寫報告時,可以請 AI 幫你生成大綱(Outline)或進行思維發散(Thought Dumping),將雜亂的子彈筆記整理成結構化的段落,但最後的撰寫與語氣修飾必須由你自己完成。
  • 意圖設定(Intentionality): 在按下 Enter 鍵發送提示詞之前,先問自己:「我是要它幫我完成任務,還是要它提供不同視角?」。

2. 利用「學習模式」與「蘇格拉底式對話」

如果你想真正學到東西,不要讓 AI 直接給出程式碼或論文。

  • 推薦做法: 使用 Claude 的「學習模式」或透過 Prompt(提示詞)要求它:「請不要直接給我答案,而是透過反問的方式引導我思考。」。
  • 複習神器: 為每一門課建立一個專屬的 AI Project(專案),上傳講義與筆記。在考前,要求 AI 用「簡潔模式」(Concise Mode)幫你快速梳理核心概念。

3. 建立「防禦底線」(The Defense Line)

如何判斷自己是否過度依賴 AI?這裡有一個黃金法則:「你必須能夠像向五年級學生解釋一樣,清楚解釋你產出的內容」。

  • 實務檢測: 如果你在課堂報告或面試中被問到某個細節,而你因為那是 AI 生成的而無法回答,那你就越界了。AI 可以是你的助手,但你必須是那個能站上台捍衛觀點的「最終魔王」(Final Boss)。

4. 擁抱「AI 流暢度」作為核心技能

不要害怕學習新工具。現在的趨勢是,非技術背景的學生也能透過自然語言(Natural Language)來控制終端機(Terminal)或寫程式。

  • 行動呼籲: 去關注那些在 Substack 或開源社群分享 AI 新玩法的專家(如 Nate Jones),像海綿一樣吸收新知,並嘗試將其應用到你的旁類專案(Side Projects)中。

給教育者與機構的建議

1. 擁抱而非禁止,引導而非漠視

禁止學生使用 AI 是徒勞的。LSE 的一門課程示範了極佳的轉型:

  • 案例: 課程不再要求學生寫傳統論文,而是要求學生提交與 AI 的對話紀錄。教授評分的重點在於:你問了什麼問題?你如何與 AI 互動?你是否有批判性地評估 AI 的回應?最後,學生需錄製影片來口頭闡述觀點,確保他們真的理解內容。

2. 將 AI 納入課程設計

像 ASU 這樣的大學已經開始積極擁抱 AI,甚至由職業中心建立「提示詞庫」(Prompt Bank)來幫助學生模擬面試與職場情境。未來的課程應該教導學生如何負責任地使用這些工具,而不是假裝它們不存在。


結語:我們會找到出路的

這場 AI 帶來的校園革命,既混亂又迷人。我們看到了作弊的隱憂,但也看到了前所未有的創造力爆發。

正如訪談結束時 Greg 所觀察到的,儘管面臨不確定性,學生們並沒有陷入「末日論」(Doomerism)。相反地,大家抱持著一種「我們會搞定它」(We’ll figure it out)的務實樂觀主義。

在這個時代,學生的責任回到了最根本的問題:你為什麼來上大學? 如果你只是為了混張文憑,AI 可以幫你輕鬆作弊過關;但如果你是為了學習與成長,AI 將是你最強大的外骨骼,幫助你走得比任何時代的學生都還要遠。

選擇權,始終在你的手中。

參考資料

  • 原影片:AI on campus [Anthropic 公司YouTube訪談]
READ MORE
AI資訊分享Build School Learn2026-01-13
Share article:TwitterFacebookLinkedin
685 Views
25 Likes

為什麼大多數 AI 產品沒成功?來自 OpenAI、Google 與 Amazon 的 50+ 次部署教訓

在 2024 到 2025 年的 AI 浪潮中,無數企業湧入 AI 領域,試圖開發出下一個顛覆性的產品。然而,現實是殘酷的:大多數 AI 產品不一定能勝出。為什麼擁有最強大的模型(如 GPT-4 或 Claude)卻無法保證產品的成功?

本文整理自 OpenAI、Google 與 Amazon 的 AI 專家 Aishwaria Raanti 與 Kiti Bottom 的實務分享,他們參與過超過 50 次 AI 產品部署,並總結出一套「持續校準與持續開發」(CC & CD)框架。如果你正掙扎於讓 AI 產品落地,或者希望避免常見的陷阱,這份深度指南將為你揭示 AI 產品開發的真諦。

一、 AI 產品與傳統軟體的本質區別

許多開發團隊失敗的第一個原因,在於他們用「開發傳統軟體」的思維來處理 AI。專家指出,AI 產品具備兩個根本性的差異:

1. 非確定性(Non-determinism)

傳統軟體(如 Booking.com)的流程是確定的:使用者點擊按鈕,系統執行預設動作,結果完全可預測。但 AI 產品面臨的是輸入與輸出的雙重非確定性:

  • 輸入端: 使用者可以使用自然語言以千萬種方式表達意圖。
  • 輸出端: 大型語言模型(LLM)本質上是機率性的黑盒子,對提示詞(Prompt)極其敏感,同樣的請求可能得到不同的結果。

2. 自主性與控制權的權衡(Agency-Control Trade-off)

這是許多開發者忽視的關鍵:當你賦予 AI 系統愈高的決策能力(自主性),你就必須放棄愈多的控制權。團隊往往過於執著於建立「全自動化 Agent」,卻忽略了系統是否已經贏得了使用者的信任,或者其可靠性是否足以支撐這些決策。


二、 核心框架:持續校準與持續開發 (CC & CD)

為了應對上述挑戰,專家提出了 CC/CD (Continuous Calibration & Continuous Development) 框架。這可以看作是 AI 時代的 CI/CD。

1. 持續開發 (Continuous Development)

這是一個獲取基準與部署的循環:

  • 定義能力範圍與數據策劃: 在動手前,先確定預期輸入與輸出。這有助於對齊團隊對產品行為的共識。
  • 設計評估指標(Evaluation Metrics): 針對不同維度定義衡量標準。
  • 部署: 將系統推向測試或生產環境。

2. 持續校準 (Continuous Calibration)

這是 AI 產品最獨特的部分,旨在捕捉非預期行為:

  • 分析行為與識別錯誤模式: 使用者在生產環境中的行為往往與測試時完全不同。
  • 修正與迭代: 發現新的錯誤模式後,除了修復問題,還要設計新的評估指標來防止退化。
  • 最小化驚喜: 校準的目標是讓系統行為變得可預測,直到團隊不再看到新的異常數據分佈,才考慮提升自主性。

三、 實務路徑:從低自主性到高自主性的進化

專家強烈建議不要試圖在第一天就達成「全自動 Agent」。相反地,應該採取「階梯式進步」:

案例研究:客戶支援 AI

  1. V1 路由與分類(高控制、低自主): AI 僅負責將工單分配給正確的部門。即使分錯,人類也能輕鬆修正。這階段的重點是解決企業內混亂的數據分類(Taxonomy)問題。
  2. V2 協作助手(中自主): AI 根據標準作業程序(SOP)產生回覆草稿,由人類審核並修改。這時系統可以免費獲得大量的錯誤分析數據,因為人類修改的部分就是 AI 的盲點。
  3. V3 端到端解決方案(高自主): 當 AI 的草稿幾乎不再被修改時,才開放自動回覆、自動退款或自動建立技術工單。

這種模式同樣適用於程式助手(從程式碼補全到自動提交 PR)或行銷助手(從草稿撰寫到自動 A/B 測試與優化)。


四、 成功的維度:領導力、文化與技術

成功的 AI 轉型不只是技術問題,而是「成功三角」的結合:領導力、文化與技術進步。

1. 領導力:親自下場(Hands-on)

AI 領域變化極快,領導者的直覺可能在三個月內過時。專家舉例,Rackspace 的 CEO 每天早上 4 到 6 點會固定排除所有會議,專門學習最新的 AI 技術與趨勢。領導者必須有勇氣承認自己可能是「房間裡最笨的人」,並重新建立對技術邊界的認知。

2. 文化:賦能而非取代

許多企業推動 AI 時會遭遇阻礙,因為領域專家(SME)擔心被 AI 取代而不願配合。成功的企業會建立「賦能文化」,強調 AI 是用來 10 倍化員工生產力的工具。

3. 技術:著迷於工作流程而非模型

80% 的 AI 工程師其實應該花時間在理解工作流程(Workflow)上,而不是追求最酷的模型。你必須極度了解企業數據的混亂程度(如:各種重複的數據標籤、技術債),才能讓 Agent 真正發揮作用。


五、 關於評估(Evals)與監控的真相

目前業界對「評估」(Evals)存在一種錯誤的二分法:認為要麼靠評估解決一切,要麼只靠線上監控。

為什麼你不能只靠評估?

「評估」這個詞已經產生了語義擴散(Semantic Diffusion),每個人定義都不同。更重要的是,評估指標只能捕捉你「已知」的錯誤。

未來建議的監控方式:

  • 顯性信號: 使用者點擊「倒讚」。
  • 隱性信號: 使用者沒有給倒讚,但點擊了「重新產生」(Regenerate),這代表初次結果未達標。
  • 回饋循環: 從生產環境中提取異常案例,將其轉化為新的評估數據集,這才是真正的進步。

六、 未來實務推薦:2026 的戰略佈局

對於希望在未來兩年保持競爭力的團隊,專家給出了以下前瞻性建議:

1. 痛苦是新的護城河(Pain is the New Moat)

現在開發 AI 的工具非常廉價,甚至可以靠 AI 寫出基礎 App。真正的護城河不再是功能,而是你經歷過多少次失敗迭代、對非確定性邊界的掌握、以及對特定業務場景的深度優化。那些願意經歷學習與實施痛苦的團隊,才能建立真正的優勢。

2. 主動型 Agent (Proactive Agents) 的興起

目前的 AI 多是被動回覆。未來的趨勢是 Agent 能夠理解背景並主動預測需求。

  • 例如:程式碼 Agent 在你上班前就已經修復了五個 Bug 並準備好 PR 讓你審核。
  • 例如:監控 Agent 發現網站流量異常,主動建議數據庫重構方案。

3. 多模態體驗 (Multimodal Experiences)

語言只是人類溝通的最後一環。未來的產品將整合影像、語音與環境理解。多模態理解將解鎖那些傳統上難以數位化的數據,如手寫文件或混亂的 PDF,這將帶來巨大的商業價值。

4. 專注於品味與判斷力

當「實現」變得極其廉價時,產品的設計(Design)、品味(Taste)與判斷力(Judgment)將成為核心競爭力。你必須具備重新思考端到端流程(End-to-end Workflow)的能力,而不是只在邊角料做自動化。


結語:回歸問題本質

在 AI 時代,最容易犯的錯就是「拿著錘子找釘子」。專家提醒我們,AI 終究只是一個工具。成功的關鍵始終在於:你是否極度著迷於客戶的問題?你是否理解他們的工作流程?

建立 AI 產品就像攀登險峻的山峰:你不會第一天就試圖攻頂,而是透過小規模的訓練、建立營地(低自主性階段),並根據天氣變化(數據回饋)不斷校準路線,最終才能安全到達終點。

如果你能擁抱「非確定性」,並在持續校準中保持耐心,你就能在這場 AI 競賽中脫穎而出。

參考資料

  • 原影片:Why most AI products fail: Lessons from 50+ AI deployments at OpenAI, Google & Amazon
READ MORE
AI資訊分享Build School Learn2026-01-13
Share article:TwitterFacebookLinkedin
606 Views
33 Likes

AI 口試時代來臨:當大型語言模型讓「真正理解」重新被評量

在生成式 AI 全面進入校園後,許多教師正面臨一個棘手卻真實的問題:
學生交出的作業愈來愈完美,但他們真的理解了嗎?

來自 紐約大學史登商學院 的資料科學教授 Panos Ipeirotis,最近就親身經歷了這種「詭異的幸福」。他的實驗不只是一門課的插曲,而是對整個高等教育評量制度的正面衝擊。


一、作業品質異常飆升,卻揭露更大的評量危機

在與 Konstantinos Rizakos 合開的《AI/ML 產品管理》課程中,Panos 發現學生的課前作業品質突然全面「升級」——
結構嚴謹、語言精煉,幾乎像顧問公司反覆修訂過的正式報告。

然而,當教師在課堂上隨機請學生解釋自己繳交的內容時,問題立刻浮現:
不少學生在被追問兩三個關鍵細節後,便無法清楚說明自己的決策邏輯,甚至完全當機。

結論非常殘酷:
如果學生連自己交出的作業都說不清楚,那這份作業就根本無法衡量其真實理解能力。

這已不只是作弊或投機,而是整個作業評量機制在 AI 時代失效。


二、為什麼「現在」必須重新思考口試?

核心原因其實很直接:
大型語言模型(LLM)已能即時完成大多數傳統作業與專題成果。

  • 課後作業 → 可隨時請 ChatGPT 協助
  • 小組專題 → AI 可生成完整簡報與講稿
  • 課堂報告 → 即使未實際參與,也能講得條理分明

Panos 坦言,真正讓他感到無力的,不再只是「搭便車」,而是教師已無從判斷誰真正參與、誰真正理解。

此時,「口試」重新浮上檯面,因為它具備三項 AI 難以取代的特性:

  • 即時推理與臨場反應
  • 對陌生問題的即時應用能力
  • 能為每一個決策提出清楚、可追溯的理由

唯一的問題只有一個:
口試長期無法規模化——除非,考官本身也是 AI。


三、用語音 AI 代理,讓口試第一次得以規模化

為了解決人力與排程的後勤噩夢,Panos 團隊選擇使用 ElevenLabs 的對話式語音 AI 平台,打造一套「AI 口試考官」。

核心設計重點

  • 動態變數注入:學生姓名、專題內容皆可個人化
  • 工作流架構:由多個子 Agent 分工,而非單一泛用模型

口試流程

  1. 討論學生專題:目標、資料來源、模型選擇依據、失敗經驗
  2. 即時案例分析:隨機抽取課堂案例,測試知識吸收程度

背後由三個子 Agent 支撐:

  • 身分驗證 Agent
  • 專題討論 Agent
  • 案例討論 Agent

這樣的設計,不只降低對話失控風險,也讓系統調校更清晰可控。


四、成本與成效:數據給出了明確答案

實際執行結果顯示:

  • 36 名學生,9 天內完成所有口試
  • 平均每人 25 分鐘
  • 每位學生成本僅 0.42 美元
  • 總成本約 15 美元(人工至少 750 美元以上)

此外,團隊引入「三模型評分委員會」:

  • Anthropic 的 Claude
  • Google 的 Gemini
  • OpenAI 的 ChatGPT

經過交叉審議後,模型間評分一致度大幅提升,證實 AI 評量是可以被校準、被監督的。


五、AI 口試的關鍵價值:讓教學盲點無所遁形

透過結構化拆解成績,Panos 團隊發現:

  • 「實驗設計」是全班最弱的能力項目
  • 無任何學生達到精通等級

這迫使教師正視一個事實:
問題不只在學生,也在課程設計本身。

更有意思的是:

  • 口試時間長短與成績完全無相關
  • 真正理解者,往往回答更精煉、效率更高

六、學生真的接受 AI 口試嗎?

調查結果相當真實:

  • 多數學生仍偏好傳統筆試
  • 83% 認為 AI 口試壓力更大
  • 但有 70% 認同它更能檢驗真實理解程度

換言之:
學生未必喜歡,但他們知道這樣更公平。


結語|AI 正在讓「真正的學習」回歸本質

Panos 的總結相當明確:

作業的時代已經結束,
回到紙筆考試只是技術上的倒退。

AI,正在讓口試重新變得可行、可規模化。

更重要的是,這套系統甚至能開放給學生反覆練習——
不是背題,而是訓練思考與表達本身。


給專業教育工作者的未來趨勢與實務建議

  1. 評量設計應從「成果導向」轉向「推理與決策歷程導向」
  2. 將 AI 視為教學診斷工具,而非單純風險來源

參考資料

  • 原文:Fighting Fire with Fire: Scalable Personalized Oral Exams with an ElevenLabs Voice AI Agent
READ MORE
AI資訊分享Build School Learn2026-01-07
Share article:TwitterFacebookLinkedin
1612 Views
56 Likes

[2026 AI 轉型]政府補助最高95~200萬! Build School協助企業導入 AI一站式服務-從OpenAI GPT/ Gemini、GitHub Copilot、M365 Copilot、Azure AI、Google Vertex AI 等工具及雲端平台

在 2026 年 AI 全面落地的時代,企業競爭力取決於員工對 AI 工具的掌握度。Build School 協助您的企業接軌世界級 AI 技術,同時透過政府補助計畫,大幅降低培訓成本,實現低負擔、高效率的數位轉型!

💰快速線上瀏覽懶人包 – https://learnaicopilot.build-school.com

  • AI課程網站: Build School Learn AI 課程地圖 | 微軟認證學習地圖

💰 2026 年度培訓補助方案總覽

無論您的公司規模大小,我們皆能協助您申請相對應的政府補助:

比較項目🏢 中小企業數位轉型培力 (經濟部)🏭 勞動部「大人提」計畫
企業人力資源提升計畫(大人提)
適用對象30 人以下 (服務/製造業)51 人以上 (中大型企業)
補助額度✅ 每人最高 $10,000
✅ 每家最高 $100,000
✅ 訓練費補助 50%~70%
✅ 年度最高 95~200 萬元
培訓形式標準班 (12小時,含6h實體)
企業包班、客製化內訓
企業包班、客製化內訓
適合情境快速導入、低門檻
中小企業數位轉型培力補助範圍:
1. 課程費用採實報實銷
2. 也可補助AI工具軟體費用
(OpenAI GPT / Gemini/ Copilot、Azure
、Azure AI、GitHub Copilot、Google Vertex AI…)
3. 提供統編之台灣統一發票,方便B2B付款及核銷
規模化人才升級
年度與長期規劃
申請期限及公告⏳ 2026年度待公告 (2025年度至2025/12/31 前)
30人以下服務業公告
30人以下製造業公告
依勞動部年度計畫公告

💡 為什麼選擇 Build School 進行 AI 培訓?

我們具備以下四大優勢:

  • AI 導入實務經驗: 近2年累積80多家企業/學校/單位客戶導入我司AI產品及培訓服務,至2025/12月止約3,200人次於我司學習微軟國際認證課程(其中微軟AI900認證累積培訓超過650人次,超過300人次取得微軟國際認證),10年軟體/AI/雲端/IT資訊專業培訓經驗,具備深厚的雲端與 AI 實務經驗,提供最前瞻的技術指導。
  • AI 落地一站式服務 : 從AI工具/平台採購、培訓、導入、顧問、到高階的微軟原廠認證(AI-102、AZ-104…),我們提供完整的AI 一站式服務,不用東找西尋。
  • 100% 實戰導向: 拒絕純理論!課程可涵蓋 Open GPT/ Gemini / NotebookLM / M365 Copilot 到 AI Agent 開發應用、 Azure AI Foundry、GitHub Copilot 及 Google Vertex AI,讓員工「早上學、下午就能用」。
  • 專業補助核銷支援: 提供標準台灣統一發票與統編,並了解勞動部「大人提」及經濟部「中小企業數位轉型培力計畫」申請規範,協助企業輕鬆完成 B2B 核銷。

🚀 專業職能 AI 升級路徑:一眼看懂您的需求

  • 你知道 Azure AI 也有 OpenAI 及其它大廠Claude等模型嗎?
  • M365 的用戶,你有將內建的 Copilot Chat 用起來嗎?
  • 只是拿來聊天? ChatGPT / Gemini 的真正行業商業應用
  • AI 工作流程自動化 – 企業內部如何開始?
  • 你知道AI 自然語言處理可以做哪些事嗎? 內容分析/分類/標籤/去識別化及知識整理,它可以
    • 分類/打標籤 (例如: 客訴分類)
    • 評價/情緒判斷 (例如: google 地標的評語,分為 好 / 中立 / 壞)
    • 判讀意圖 (例如:從文字中了解使用者想做什麼)

我們不只教工具,更教如何將 AI 嵌入工作流。針對企業不同角色,量身打造AI升級路徑:

👀 眼見為憑:拒絕空談,我們只教能落地的 AI 技術

Demo: AI 應用與開發: 我的一日穿搭 OOTD

⚠️ 為什麼現在是最佳時機?

  • 告別繁瑣規劃: 內訓成本高?Build School 協助盤點需求,精準定位培訓方向。
  • 政府強力支持: 2026 年是數位轉型補助的高峰期,名額有限,額滿即止。
  • 提升員工產值: 導入 AI 協作可節省煩索的作業處理時間,讓團隊專注高價值決策及產出。

📞 立即諮詢,搶佔補助名額!

別讓複雜的文件阻礙企業升級,讓 Build School 成為您的強力加速器。

  • 諮詢信箱: contact@build-school.com
  • 快速聯繫: 歡迎至 Build School Learn 官網右下角「聊聊」與我們聯繫
READ MORE
AI資訊分享Build School Learn2026-01-07
Share article:TwitterFacebookLinkedin
1631 Views
29 Likes

Claude Code 高效工作流實戰:Claude Code 的創建者Boris Cherny 的 12 個開發技巧

2026 年新年第三天,Claude Code 的創建者與負責人 Boris Cherny 進行了一場「線上示範教學」,公開他自己日常使用 Claude Code 的實戰工作流。最讓人意外的是:他的設定其實非常「素」——因為 Claude Code 開箱即用就已經很強,他更在意的是把工作流流程化、把回饋閉環做扎實,而不是花大量時間做酷炫客製化。

以下整理成一篇面向專業開發者/工程主管/技術 PM 的實務筆記:你可以把它當成一套可直接套用的「AI 程式開發作業系統」。

1) 五線並行:同時跑 5 個 Claude 視窗,提升吞吐量

Boris 會在終端機同時開 5 個 Claude 視窗(分頁標上 1~5),並開啟系統通知。當某個任務需要他補充指令或做決策時,他能立刻被提醒,不會讓工作流卡住。

為什麼這招有效(給專業人士的觀點)

  • AI 寫碼常見瓶頸不是「產出速度」,而是「等待你回覆」或「等待驗證結果」。多視窗等於把等待時間攤平,提升整體 throughput。
  • 特別適合:多個 feature/bug 同時推進、同時跑測試或查資料的情境。

2) 多端無縫衔接:終端 + 網頁 + 手機,讓任務隨時續跑

除了本地終端,他也會在網頁端同時跑 5~10 個任務,並在不同端之間切換:

  • 在終端寫碼時,會用 & 把會話丟到背景跑
  • 或直接在 Chrome 開新會話
  • 有時用 --teleport 在終端與網頁端之間「傳送」進度
  • 甚至每天早上用手機(iOS Claude App)先開幾個會話,回到電腦再看成果

實務建議

  • 把「需要長時間生成 / 搜集資訊 / 進行多步推理」的任務,放到你不在電腦前也能跑的地方。
  • 把「需要你頻繁介入」的任務留在終端主工作區,降低切換成本。

3) 全力投入 Opus 4.5:寧可大一點,也要少引導、少返工

他會把所有任務都開 Opus 4.5(含 Thinking 模式),原因是:雖然它比 Sonnet 更大、更慢,但更聰明、更會用工具,不需要你費力「教它怎麼想」,最終反而更快完成任務(因為少走彎路、少重做)。

給技術管理者的判斷框架

  • 如果你的工作型態是「需求模糊、整合多工具、需要端到端驗證」,大模型常常更划算。
  • 如果是「明確需求、可拆很細、測試很完整」,小模型可能就足夠且更省成本。

4) 共享知識庫 CLAUDE.md:把錯誤變成規則,讓團隊越用越順

他們團隊共用一份 CLAUDE.md 放在 Git repo 裡,大家每週會更新多次。只要發現 Claude 哪裡做錯,就把規則寫進 CLAUDE.md,避免下次再犯。

這其實是把「個人提示技巧」升級為「團隊制度」

  • 不靠每個人私藏 prompt,而是把最佳實務變成版本化文件
  • 新人加入也能快速對齊風格、規範與踩雷點

5) 持續複利:Code Review 時把規範沉澱回 CLAUDE.md

在 PR code review 時,他會常用 @.claude 讓 Claude 把同事 PR 中出現的規範、慣例或踩雷點,整理沉澱回 CLAUDE.md。他們也透過 /install-github-action 裝了 Claude Code 的 GitHub Action——這就是他們版本的「複利工程(Compounding Engineering)」。

專業價值

  • Code review 不只是「抓錯」,更是「更新組織記憶」
  • 你每修一次,就等於把未來 N 次重複錯誤的成本砍掉

6) 先謀定而後動:Plan 模式把方案打磨到可一波完成

大多數任務都從 Plan 模式開始(連按兩次 Shift+Tab)。如果目標是做一個 PR,他會先在 Plan 模式跟 Claude 反覆確認方案,直到覺得可行、可落地,再切換到 auto-accept edits 讓 Claude 直接「一波帶走」。

重點:不是「讓 AI 寫碼」,而是「讓 AI 先設計好」

  • 設計品質決定實作品質
  • 方案越清晰,後面越少來回、越少不必要的 patch

7) 自製 Slash Commands:把高頻內環流程封裝成命令

他會把每天重複多次的「內環工作流」封裝成 slash commands,放在 .claude/commands/ 並提交到 Git。這能減少重複輸入 prompt,也讓 Claude 直接呼叫固定流程。

例如他們每天用數十次 /commit-push-pr:用內聯 Bash 預先計算 Git 狀態等資訊,跑得很快,避免反覆對話成本。

你可以立刻照做的方向

  • 把「固定步驟」交給命令:建立分支、跑格式化、跑測試、寫 commit message、推 PR、生成 changelog
  • 讓 prompt 變成「工具化」而不是「口語化」

8) 善用子智能體 Subagents:把常見流程模組化

他常用特定 subagents:

  • code-simplifier:在完成後簡化程式碼
  • verify-app:端到端測試

本質上就是把 PR 中最常見的流程模組化、自動化,避免每次從零描述。

專業觀點

  • Subagent 是「角色 + 任務邊界」:讓 AI 知道自己要做的是簡化、驗證、重構或安全檢查,而不是「什麼都做一點」。
  • 對團隊來說也更容易對齊:每個 subagent 就是一套可被 code review 的流程。

9) 自動程式碼美化:用 PostToolUse Hook 補最後 10%

他們用 PostToolUse hook 做格式化。即使 Claude 寫的程式碼格式已經不錯,hook 仍能補齊最後 10% 細節,降低 CI 因格式或 lint 失敗而紅燈的機率。


10) 權限管理:不跳過提示,而是預先授權安全指令

他不使用 --dangerously-skip-permissions(危險跳過權限提示)。相反會用 /permissions 先授權在當前環境下安全、常用的 Bash 指令,並把設定存進 .claude/settings.json 供團隊共享。

對企業/資安更友善的做法

  • 把「可執行指令範圍」明確化、版本化
  • 降低意外執行破壞性操作的風險,也更容易審計

11) 工具全家桶:讓 Claude 真的『在幫你做事』而不是只給建議

Claude Code 會幫他操作各種工具:透過 MCP 伺服器搜尋並發 Slack 訊息、跑 bq CLI 做 BigQuery 查詢、從 Sentry 抓錯誤日誌等。Slack 的 MCP 設定放在 .mcp.json,團隊共用。

專業重點

  • 真正能提升生產力的不是「AI 會寫程式」,而是「AI 會把資訊與工具串起來,減少人肉搬運」。
  • 這會直接影響 MTTR(平均修復時間)、交付速度、跨部門溝通成本。

12) 長時間任務:驗證智能體、Stop Hook、以及降低打斷的權限策略

對耗時任務,他會:

  • 完成後啟動背景智能體做驗證
  • 使用 Stop hook 做確定性檢查
  • 使用 ralph-wiggum 插件
    並在需要長時間不中斷輸出時,視情況使用 --permission-mode=dontAsk,或在沙盒環境使用跳過權限模式,避免被權限彈窗卡住節奏。

最關鍵:建立回饋閉環,品質可提升 2~3 倍

Boris 強調:要拿到高品質結果,關鍵是讓 Claude 有辦法驗證自己的工作。一旦有回饋閉環,品質能提升 2~3 倍。

例如:Claude 更新網頁端程式碼時,會透過 Chrome 插件實測每次改動——自動開瀏覽器、測 UI、迭代直到跑通且互動順暢。

驗證方式因領域而異:

  • 可能是跑 Bash 腳本
  • 跑測試套件
  • 在模擬器跑 App
    請務必把「驗證流程」打造得足夠堅固,因為這會直接決定你能不能放心把修改交給自動化。

未來趨勢/實務建議(給專業人士)

  1. AI 工程會從「提示技巧」走向「可版本化的流程資產」
    像 CLAUDE.md、slash commands、subagents、hooks、permissions 白名單,這些會逐漸變成新一代工程團隊的「流程基礎建設」。建議你把它們當成 repo 的一級公民:可 review、可追溯、可迭代。
  2. 驗證(Testing/Observation)會成為 AI 開發效率的第一優化點
    當 AI 參與程度越高,你越需要把測試、lint、E2E、可觀測性(Sentry/Logs/Tracing)串成一條穩定的回饋管線。想提升交付速度,不要只盯模型與 prompt,優先投資在「更快、更可靠的驗證」。

參考資料

  • 建議參考:Anthropic 官方文件(Claude、Claude Code、MCP 相關)
  • 建議參考:GitHub Actions 官方文件(CI/CD 與自動化工作流)
  • 建議參考:Sentry 官方文件(錯誤追蹤與可觀測性)
  • 建議參考:Google BigQuery CLI(bq)官方文件(資料查詢與指令操作)
  • 建議參考:端到端測試框架官方文件(例如 Playwright / Cypress,用於建立 UI 驗證閉環)
READ MORE
  • 1
  • 2
  • 3
  • 4
  • …
  • 6
Search
Recent Posts
  • 產品簡介-AI GPT 學校共用版-AI 模型 API服務(適用於Codex及Agent代理)或Claude/Claude Code本地版本
    產品簡介-AI GPT 學校共用版-AI 模型 API服務(適用於Codex及Agent代理)或Claude/Claude Code本地版本
    2026-08-12
  • AI 時代產品人的新修煉:為何「主動性」比「技能」更關鍵 – 深度解析 Notion 產品負責人 Max Schoening 的產品建構哲學
    AI 時代產品人的新修煉:為何「主動性」比「技能」更關鍵 – 深度解析 Notion 產品負責人 Max Schoening 的產品建構哲學
    2026-05-04
  • 【深度解讀】OpenAI 總裁 Greg Brockman 最新對談:邁向 AGI 的進程與「人類注意力」的稀缺時代
    【深度解讀】OpenAI 總裁 Greg Brockman 最新對談:邁向 AGI 的進程與「人類注意力」的稀缺時代
    2026-05-04
  • 邁向通用人工智慧 (AGI) 的架構與科學發現的新紀元:Google DeepMind CEO Demis Hassabis 專訪深度解析
    邁向通用人工智慧 (AGI) 的架構與科學發現的新紀元:Google DeepMind CEO Demis Hassabis 專訪深度解析
    2026-05-04
  • AI 時代:「智能體工程」崛起,你的「理解力」是無法被取代的
    AI 時代:「智能體工程」崛起,你的「理解力」是無法被取代的
    2026-05-04
Tags
Agent AI AI900 AI GPT企業共用版 AI GPT學校共用版 AZ900 ChatGPT Claude模型 Copilot DAX query GitHub Copilot Google Gemini模型 gpt-image-1模型 Microsoft Certification PL900 Power BI Registration SC900 平台使用教學 微軟 Microsoft Azure OpenAI 微軟認證 生成式 AI GPT 學校共用版 自主學習 註冊方法 類似 ChatGPT介面
Build School Logo

We support corporate clients in driving business success, while empowering AI-driven knowledge workers to achieve their career goals.

FacebookInstagramYoutube

Useful links

AI One-stop shop Services

AI Subsidy Program

Microsoft Certificate/Certiport Testing Center

Blog : AI Insightful

About Us | FAQ

Service Terms and Conditions

Privacy Policy

Learning

Microsoft Certification Learning Roadmap

Azure / Azure DevOps Exam

Power Platform Exam / Power BI

Cyber Security

AI (ChatGPT/Gemini/Copilot/Azure AI/GitHub Copilot)

AI, Cloud, Software Engineering Bootcamp – Taipei/HsinChu

Contact Us

11Fl.-1, No.96, Sec.3, Chung Hsiao E. Rd., Taipei, Taiwan

Live Chat Messenger

bslearn@mail.build-school.com

© Copyright 2025 by Build School 青杉人才 | 青群科技. All rights reserved.

Our website uses cookies to provide you the best experience. By continuing to use our website, you agree to our use of cookies. More information,

Login

Please register and login by your Google or Microsoft account.

請使用第三方身份驗證服務進行登錄。

Continue with Google
Continue with Microsoft
Lost Your Password?
Build School Logo
Register
Don't have an account? Register one!
Register an Account
  • English
  • 繁體中文 (Chinese (Traditional))
  • 日本語 (Japanese)